Diff:基于分数与扩散的生成建模三篇奠基性论文
Diff:基于分数与扩散的生成建模三篇奠基性论文
好久没有写过这种长篇幅博客了,趁国庆节重温了一下图像生成领域的一些论文,又有了很多新的感悟。本报告按三篇论文的原始章节顺序展开:
- SMLD / NCSN - Generative Modeling by Estimating Gradients of the Data Distribution(Song & Ermon,NeurIPS 2019,arXiv:1907.05600v3)。
- DDPM - Denoising Diffusion Probabilistic Models(Ho, Jain, Abbeel,NeurIPS 2020,arXiv:2006.11239v2)。
- Score-SDE - Score-Based Generative Modeling through Stochastic Differential Equations(Song, Sohl-Dickstein, Kingma, Kumar, Ermon, Poole,ICLR 2021,arXiv:2011.13456v2)。
序言:三篇论文之间的联系
这三篇论文构成了一条单一的思想谱系。SMLD 确立了核心思想:用分数匹配(score matching)学习数据分布的分数(score,即对数密度的梯度),然后沿该向量场移动来完成采样。它指出了朴素实现的两大失效模式:流形假设(manifold hypothesis)与低密度区域(low-density region),并通过在多个噪声尺度上扰动数据、以及使用退火(annealed)Langevin 动力学采样来同时解决二者。
DDPM 从变分推断一侧处理同一问题:它定义一个固定的高斯前向马尔可夫链来破坏信号,再训练一个高斯逆向链重建信号,并优化变分界。其核心发现是:对逆向过程均值采用某种特定参数化(即“$\epsilon$ 预测”)后,该变分界会变得看起来像多个噪声尺度上的去噪分数匹配,从而把两大流派联系起来。
Score-SDE 则彻底去掉了离散性:它用连续时间随机微分方程(SDE)取代有限的噪声尺度集合,证明 SMLD 与 DDPM 分别是方差爆炸型(Variance Exploding)与方差保持型(Variance Preserving)SDE 的离散化;它推导了仅依赖分数的逆向时间 SDE,并导出了可给出精确似然的概率流常微分方程(probability-flow ODE)。它还贡献了 PC 采样器(Predictor–Corrector Sampler)、sub-VP SDE,以及条件生成/逆问题求解。全文交叉引用记作 [SMLD, §4.2]、[DDPM, §3.4]、[Score-SDE, §4.3]。
SMLD
论文开篇指出,生成建模由两大家族主导:基于似然的模型(自回归模型、归一化流、通过 ELBO 训练的变分自编码器、通过对比散度训练的基于能量的模型)与生成对抗网络(GAN)。二者各有内在局限:基于似然的方法要么必须使用特殊架构以保持归一化密度可计算,要么优化代理目标;而 GAN 则因对抗训练而不稳定,且缺乏可用于模型比较的有原则的目标。其它目标(如噪声对比估计、最小概率流)通常只在低维下表现良好。
SMLD 提出一个不同的原理:估计并采样自对数密度的 (Stein) 分数 $\nabla_x \log p(x)$ (一个指向对数密度增长最快方向的向量场)。一个神经网络通过分数匹配学习逼近该向量场,随后使用 Langevin 动力学产生样本,即从随机初始点出发,沿估计的向量场逐步移向高密度区域。
引言随后点出两个核心障碍。其一,若数据位于嵌入 $\mathbb{R}^D$ 的低维流形上,分数在环境空间中无定义,分数匹配也不是一致估计。其二,在低密度区域训练数据稀少,分数估计不准确,Langevin 混合也缓慢(当模态被低密度势垒分隔时尤甚)。所提出的补救办法是:在多个噪声幅度上用高斯噪声扰动数据,训练单一的噪声条件分数网络,并采用退火 Langevin 方案——从最大噪声尺度开始、逐渐降低噪声。作者声称该方法灵活(无需特殊架构、无需对抗训练、训练时无需采样),并给出一个可用于模型比较的定量学习目标。实验上,它在 CIFAR-10 上取得了当时最先进的 Inception 分数 8.87、FID 25.32,并通过图像修复说明其学到了有用的表示。
基于分数的生成建模
本节固定记号并给出两个要素。数据集为服从未知分布 $p_{\text{data}}(x)$ 的独立同分布样本 ${x_i \in \mathbb{R}^D}_{i=1}^N$。 $x$ 是一个多维向量,它是 1 个图片,也是全空间的 1 个数据点。 密度的分数即 $\nabla_x \log p(x)$;分数网络 $s_\theta : \mathbb{R}^D \to \mathbb{R}^D$ 被训练来逼近数据分数:$s_\theta(x)\approx \nabla_x \log p_{\text{data}}(x)$。框架被明确拆分为 (i) 用于估计的分数匹配 与 (ii) 用于采样的 Langevin 动力学。
用于分数估计的分数匹配
分数匹配最初由 Hyvärinen 提出,用于直接从样本学习非归一化模型,其准则类似 Fisher 散度。本文沿用先前工作,将其改造为直接估计分数,并刻意不把分数建模为基于能量的模型的梯度(以避免高阶梯度计算)。目标函数
$$ \frac{1}{2} , \mathbb{E}_{p_{\text{data}}} [| s_\theta(x)- \nabla_x \log p_{\text{data}}(x)|_2^2] $$
证明前置知识: (1) 乘以自身对数的梯度即等于自身的梯度. (2) 与向量场乘积的散度等于自身乘以场的散度再加上场乘自身梯度. (3) 散度的区域积分等于边界上的外法向通量. (4) 向量场的散度等于向量场的梯度求迹.
被证明在相差一个常数意义下等价于
$$ \mathbb{E}_{p_{\text{data}}(x)} [\operatorname{tr}(\nabla_x s_\theta(x))+ \frac{1}{2} | s_\theta(x)|_2^2],\tag {SMLD 式 1} $$
其中 $\nabla_x s_\theta(x)$ 为雅可比矩阵。在正则条件下,最优解 $s_{\theta^\star}(x)$ 几乎处处等于 $\nabla_x \log p_{\text{data}}(x)$。问题在于可扩展性:迹项在高维下代价高昂,因此论文讨论两种可扩展的变体。
去噪分数匹配(DSM) 通过先用固定噪声分布 $q_\sigma(\tilde x \mid x)$ 扰动每个数据点、并匹配扰动后密度 $q_\sigma(\tilde x)= \int q_\sigma(\tilde x \mid x)p_{\text{data}}(x), dx$ 的分数,绕开了迹的计算。其目标等价于
$$ \frac{1}{2} , \mathbb{E}_{q_\sigma(\tilde x\mid x)p_{\text{data}}(x)} [| s_\theta(\tilde x)- \nabla_{\tilde x} \log q_\sigma(\tilde x \mid x)|_2^2]. \tag{SMLD 式 2} $$
最优解满足 $s_{\theta^*}(x)= \nabla_x \log q_\sigma(x)$ 几乎处处成立,但是 $q_\sigma(x)\approx p_{\text{data}}(x)$ 仅在 $\sigma$ 足够小时成立。
切片分数匹配(SSM) 则用随机投影 $v$ 逼近迹:
$$ \mathbb{E}_{p_v} \mathbb{E}_{p_{\text{data}}} [v^\top \nabla_x s_\theta(x), v + \frac{1}{2} | s_\theta(x)|_2^2],\tag {SMLD 式 3} $$
其中 $p_v$ 是简单分布(如标准正态)。项 $v^\top \nabla_x s_\theta(x)v$ 可用前向模式自动微分高效计算。与 DSM 不同,SSM 面向未扰动数据分布,但计算量约多四倍。
用 Langevin 动力学采样
Langevin 动力学把分数函数变成采样器。给定固定步长 $\epsilon > 0$ 与初值 $\tilde x_0 \sim \pi(x)$,
$$ \tilde x_t = \tilde x_{t-1} + \frac{\epsilon}{2} \nabla_x \log p(\tilde x_{t-1}) + \sqrt{\epsilon} , z_t,\qquad z_t \sim \mathcal{N}(0,I). \tag{SMLD 式 4} $$
当 $\epsilon \to 0$、$T \to \infty$ 时,在正则条件下 $\tilde x_T$ 成为精确样本;在有限 $\epsilon,T$ 下形式上需要 Metropolis–Hastings 校正,但实践中常可忽略。关键观察是:该更新只需要分数,因此若 $s_\theta \approx \nabla_x \log p_{\text{data}}$,便可近似地从 $p_{\text{data}}$ 采样——这正是整个框架的核心思想。
基于分数的生成建模所面临的挑战
论文论证,朴素的“分数匹配 + Langevin”会面临两个障碍,并分别加以分析。
障碍一:流形假设
真实数据倾向于集中嵌入在高维环境空间中的低维流形上。由此产生两个问题。(1) 分数是环境空间中的梯度,当 $x$ 被限制在低维流形上时它是无定义的。(2) 分数匹配目标仅在数据支撑为全空间时给出一致估计,因此在流形上会不一致。说人话就是,低维流形在全空间的体积为 0,因此它的密度根本无法定义,也就不存在密度的对数梯度;而在匹配过程中,由于数据本身仅支撑少量维度,还有有大量未支撑的维度仍然不能确定,因此匹配目标和过程会无法确定。
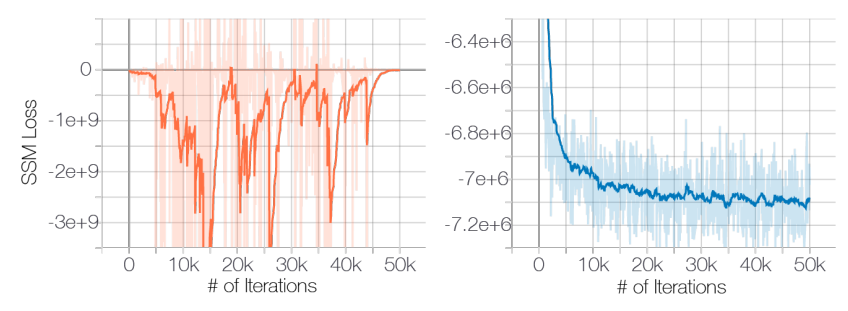
为说明这一点,作者在 CIFAR-10 上用切片分数匹配训练一个 ResNet 自编码器(图 1)。在原始图像上,SSM 损失先下降、随后不规则波动;一旦用极小的噪声 $\mathcal{N}(0,0.0001)$ 扰动数据(对 $[0,1]$ 像素而言肉眼不可辨)损失便收敛。这确认了“在 $\mathbb{R}^D$ 上具有全支撑”正是分数估计稳定的原因。
障碍二:低密度区域
低密度区域数据稀少,这会同时损害分数估计与 Langevin 混合。
分数匹配在低密度区估计不准
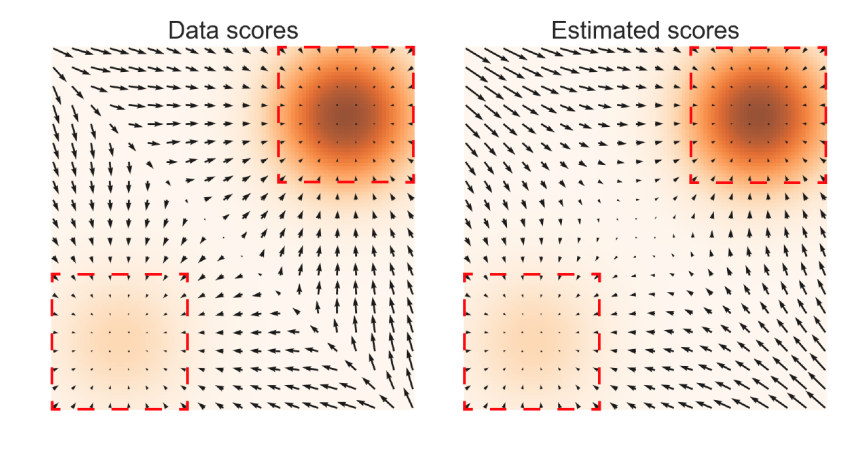
由于分数匹配损失是 $p_{\text{data}}$ 下、由独立同分布样本估计的期望,任何满足 $p_{\text{data}}(R)\approx 0$ 的区域 $R$ 通常没有样本,分数便无法在那里估计。一个双模态混合分布的玩具实验(这里假设图片是 1 个 2 维数据点,是降维打击)
关于模态混合的理解:我们将各数据点当作独立同分布的多个模态,并假设单个模态是以各数据点为中心的多维独立正态分布,将真实的数据分布近似地看作这些模态的线性混合。
$$ p_{\text{data}} = \tfrac{1}{5} , \mathcal{N}((- 5,- 5),I)+ \tfrac{4}{5} , \mathcal{N}((5,5),I) $$
使用 3 层 MLP、以 SSM 训练(图 2),结果表明估计只在模态附近可靠;红色矩形(即 $s_\theta \approx \nabla \log p_{\text{data}}$ 的区域)仅位于高密度处。也就是分数估计只有在数据集囊括的地方准确!(废话)
Langevin 动力学的混合缓慢
当两个模态被低密度区域分隔时,Langevin 动力学无法在合理时间内恢复正确的相对模态权重。作者借用先前那个玩具实验的论证:对于支撑不相交的 $p_{\text{data}}(x)= \pi p_1(x)+(1 - \pi)p_2(x)$,在 $p_1$ 的支撑内
$$ \nabla_x \log p_{\text{data}}(x)= \nabla_x(\log \pi + \log p_1(x))= \nabla_x \log p_1(x), $$
对 $p_2$ 同理。因此分数不依赖于 $\pi$,用其采样也无法反映 $\pi$。该分析可推广到“支撑近似不相交、由低密度桥连接”的情形:此时正确采样在理论上可行,但需要极小的步长与极多的步数。
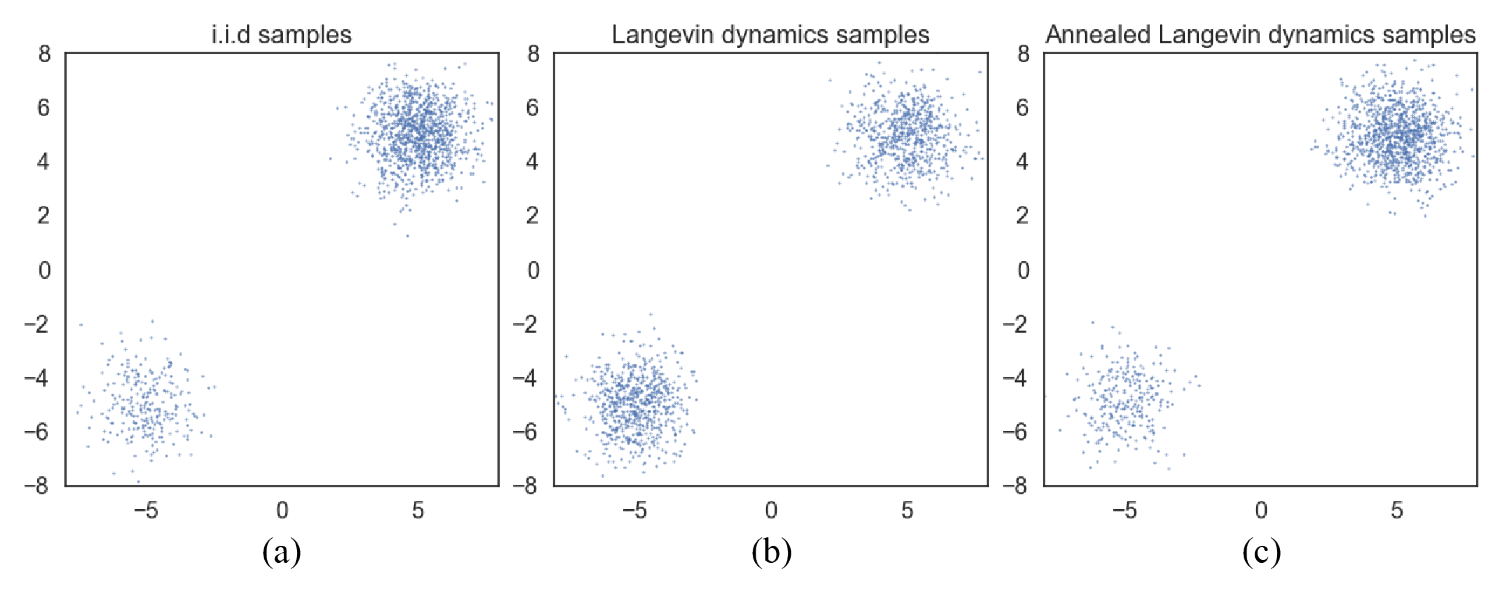
这一点用真值分数在同一高斯混合上得到验证(图 3):标准 Langevin(图 3b)相较于精确采样(图 3a)错误估计了相对模态权重,而退火 Langevin(图 3c)则忠实恢复。该结论通过把采样器与估计误差隔离开的受控实验得到确认。从这两个挑战出发,原论文提出了噪声条件分数网络。
噪声条件分数网络:学习与推断
论文先给出了动机性直觉:加入高斯噪声 (i) 使扰动分布具有全支撑,从而消除流形困难;(ii) 填平低密度区域,使分数匹配获得更多训练信号;(iii) 提供一列连接平滑噪声分布与数据的中间分布,可借鉴模拟退火与退火重要性采样的思想改善混合。因此方法为:(1) 在多个噪声水平上扰动数据;(2) 训练单一条件网络为所有噪声水平打分,再在采样时退火噪声(diffusion 的雏形)。
噪声条件分数网络
设 ${\sigma_i}_{i=1}^L$ 为正的等比数列,满足 $\sigma_1 / \sigma_2 = \cdots = \sigma_{L-1} / \sigma_L > 1$,并令
$$ q_\sigma(\tilde x)= \int p_{\text{data}}(x), \mathcal{N}(\tilde x \mid x,\sigma ^2 I), dx = \frac{1}{N(2\pi\sigma^{2})^{d/2}} \sum_{i=1}^N \exp(- \frac {|\tilde x-x_{i}|^{2}}{2\sigma^{2}}) $$
为扰动后密度(较原论文公式有改动)。最大噪声 $\sigma_1$ 的选取目标是缓解第 3 节的困难;最小噪声 $\sigma_L$ 则小到几乎不可见。网络是一个单一条件分数网络
$$ s_\theta(x,\sigma)\approx \nabla_x \log q_\sigma(x)\quad \forall \sigma \in{ \sigma_i}_{i=1}^L, $$
称为噪声条件分数网络(NCSN)。由于输出与输入图像形状相同,架构借鉴稠密预测设计:带空洞(膨胀)卷积的 U-Net,以及实例归一化;噪声水平通过改进的条件实例归一化注入,使 $s_\theta(x,\sigma)$ 以 $\sigma_i$ 为条件。
用分数匹配学习 NCSN
切片与去噪分数匹配都能训练 NCSN;论文选择去噪分数匹配,因其略快且天然契合“估计噪声扰动分布的分数”这一任务。取 $q_\sigma(\tilde x \mid x)= \mathcal{N}(\tilde x \mid x,\sigma^2 I)$,故 $\nabla_{\tilde x} \log q_\sigma(\tilde x \mid x)= -(\tilde x - x)/ \sigma^2$,逐噪声目标为
$$ \ell(\theta;\sigma)\triangleq \frac{1}{2} , \mathbb{E}_{p_{\text{data}}(x)} \mathbb{E}_{\tilde x\sim\mathcal{N}(x,\sigma^2 I)} [| s_\theta(\tilde x,\sigma)+ \frac{\tilde x-x}{\sigma^{2}} |_2^2]. \tag {SMLD 式 5} $$
这里实际上匹配的是带噪后的分数。合并所有噪声水平,
$$ \mathcal{L}(\theta;{\sigma_i}_{i=1}^L)\triangleq \frac{1}{L} \sum_{i=1}^L \lambda(\sigma_i), \ell(\theta;\sigma_i),\tag{SMLD 式 6} $$
其中 $\lambda(\sigma_i)> 0$ 为权重。由于这是 DSM 目标的锥组合,最优 $s_{\theta^\star}$ 对每个 $i$ 几乎处处都满足 $s_{\theta^\star}(x,\sigma_i)= \nabla_x \log q_{\sigma_i}(x)$。权重的选取基于如下经验观察:训练良好的网络满足 $| s_\theta(x,\sigma)|_2 \propto 1 / \sigma$;令
$$ \lambda(\sigma)= \sigma^2 $$
便使 $\lambda(\sigma)\ell(\theta;\sigma)= \tfrac{1}{2} \mathbb{E}[| \sigma s_\theta(\tilde x,\sigma)+ \tfrac{\tilde x-x}{\sigma} |_2^2]$,且因 $(\tilde x - x)/ \sigma \sim \mathcal{N}(0,I)$、$| \sigma s_\theta |_2 \propto 1$,各水平的量级大致相等。论文强调,该目标无需对抗训练、无需代理损失、训练时无需 MCMC、也无需特殊架构;且在 $\lambda$ 与 ${\sigma_i}$ 固定时,可用于跨模型的定量比较。
通过退火 Langevin 动力学进行 NCSN 推断
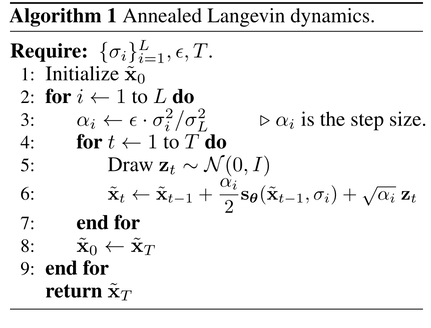
由于我们之前的分数模型是在带噪的数据上学习的,这一步我们需要在 Langevin 动力学的过程中去噪。具体做法是,推断时依次在每个噪声水平上运行 Langevin 动力学,并用上一水平的终点初始化下一水平(算法 1)。从固定先验(如均匀噪声)出发,对 $i = 1,\dots,L$ 步长为
$$ \alpha_i = \epsilon \cdot \frac{\sigma_{i}^{2}}{\sigma_{L}^{2}}, $$
内层更新(对 $t = 1,\dots,T$)为
$$ \tilde x_t = \tilde x_{t-1} + \frac{\alpha_{i}}{2} , s_\theta(\tilde x_{t-1}, \sigma_i)+ \sqrt{\alpha_{i}} , z_t . $$
为什么可以完成第 $i$ 水平后,其终点初始化第 $i + 1$ 水平呢? 理由具有几何直观:每个 $q_{\sigma_i}$ 都有全支撑,分数处处有定义;大的 $\sigma_1$ 使模态更不孤立、混合更快;来自 $q_{\sigma_1}$ 的样本位于高密度区,因而也是 $q_{\sigma_2}$ 的良好初值,如此逐级下降至 $q_{\sigma_L} \approx p_{\text{data}}$。
$\alpha_i$ 的公式是怎么确定的呢? 步长调度 $\alpha_i \propto \sigma_i^2$ 通过控制 Langevin 更新中的信噪比来论证:
$$ \mathbb{E} [| \frac{\alpha_{i}}{2} \frac{s_{\theta}(x,\sigma_{i})}{\sqrt{\alpha_{i}},z} |_2^2] \approx \mathbb{E}[\frac{\alpha_{i},|s_{\theta}(x,\sigma_{i})|_{2}^{2}}{4}] \propto \frac{1}{4} , \mathbb{E}[| \sigma_i s_\theta(x,\sigma_i)|_2^2]\propto \frac{1}{4}, $$
在 $| \sigma s_\theta | \propto 1$ 下它与 $\sigma_i$ 无关。一个 $L = 10$、$\sigma_1 = 20$、$\sigma_{10} = 1$ 的玩具实验(图 3)确认:退火 Langevin 能恢复正确的模态权重,而朴素 Langevin 失败——即它在经验上解决了 §3.2.2 的混合缓慢问题。
实验
设置。 数据集为 MNIST、CelebA(先中心裁剪为 $140 \times 140$ 再缩放为 $32 \times 32$)与 CIFAR-10;像素缩放到 $[0,1]$。噪声集合为等比序列,$L = 10$、$\sigma_1 = 1$、$\sigma_{10} = 0.01$($\sigma = 0.01$ 的噪声肉眼不可辨)。退火 Langevin 每水平 $T = 100$ 次迭代、$\epsilon = 2 \times 10^{-5}$、初始为均匀噪声;结果对 $T$ 稳健,且 $\epsilon \in[5 \times 10^{-6},5 \times 10^{-5}]$ 通常可行。
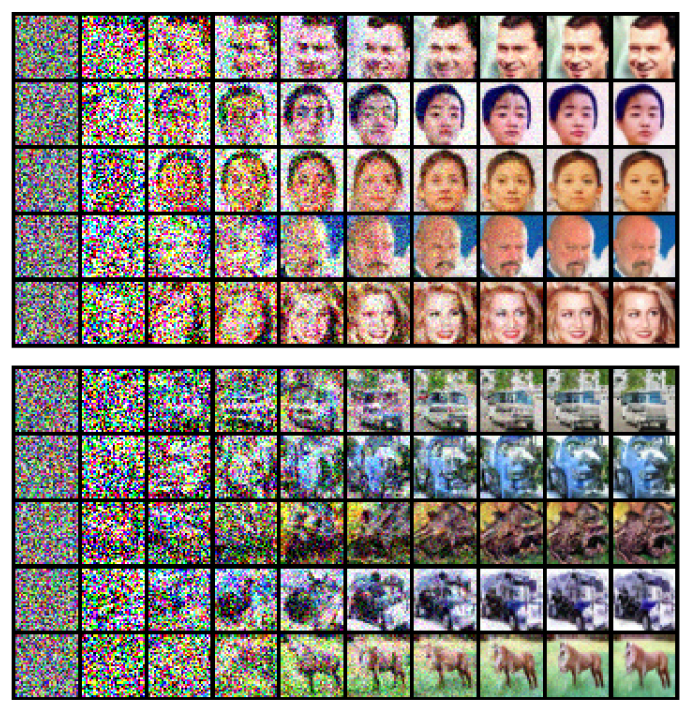
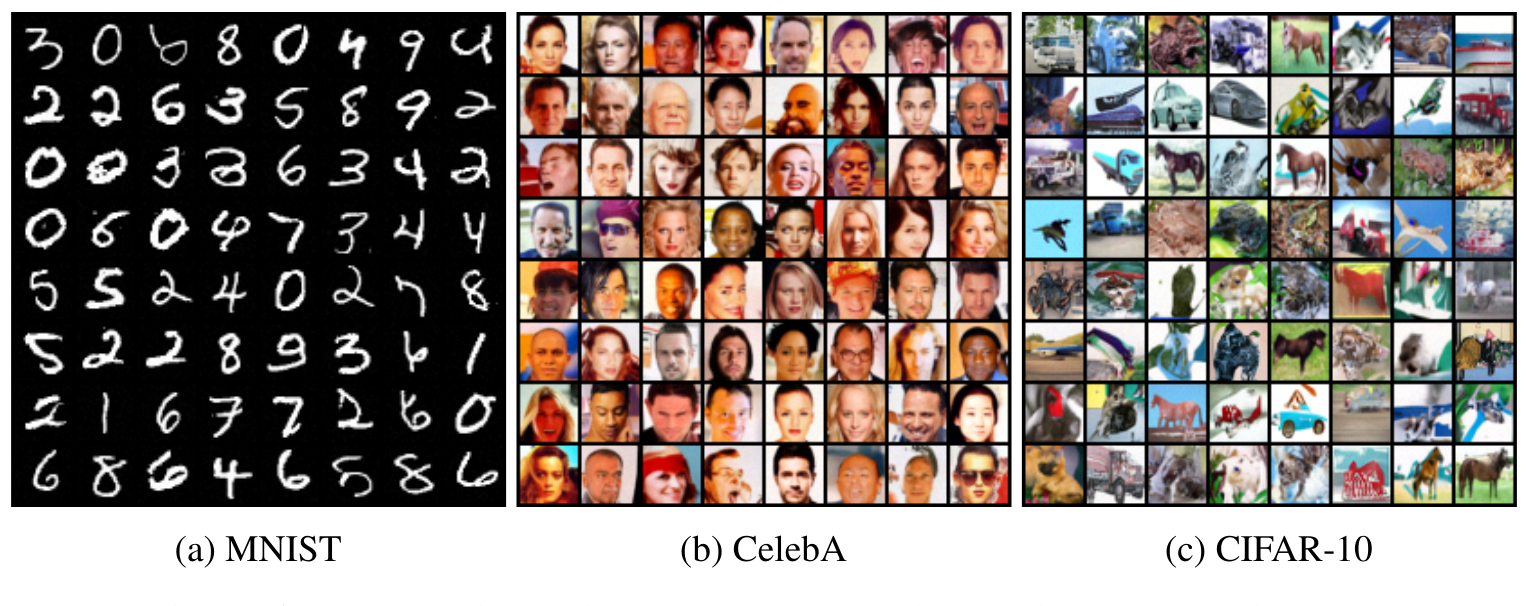
图像生成。 未筛选样本(图 5)与当代似然模型和 GAN 相当或更好;中间样本(图 4)展示从噪声到图像的过程。近邻搜索(附录 C.2)在像素空间与 Inception-v3 特征空间均表明模型并非简单记忆训练图像。单噪声水平基线(${\sigma_1 = 0.01}$ 配朴素 Langevin)无法生成合理图像(附录 C.1);论文解释:$0.01$ 足以规避流形问题,却太小,无法提供低密度区域的分数信息。
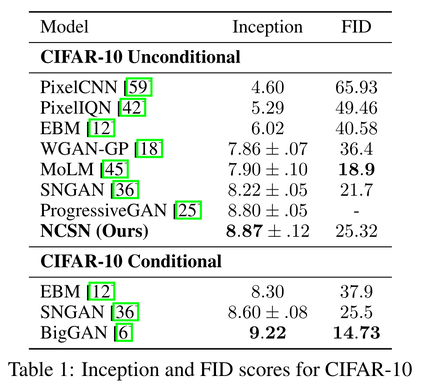
CIFAR-10 定量结果(表 1)。 NCSN(无条件)达到 Inception 8.87 ± 0.12、FID 25.32。基线:PixelCNN 4.60 / 65.93,PixelIQN 5.29 / 49.46,EBM 6.02 / 40.58,WGAN-GP 7.86 / 36.4,MoLM 7.90 / 18.9,SNGAN 8.22 / 21.7,ProgressiveGAN 8.80 / –。类条件基线:EBM 8.30 / 37.9,SNGAN 8.60 / 25.5,BigGAN 9.22 / 14.73。因而新的无条件 IS 纪录 8.87 超过了多数条件模型,FID 25.32 也具有竞争力(如与 SNGAN 相当)。MNIST 与 CelebA 的分数被省略,因为预处理/数据集约定不同,数字不可直接比较。
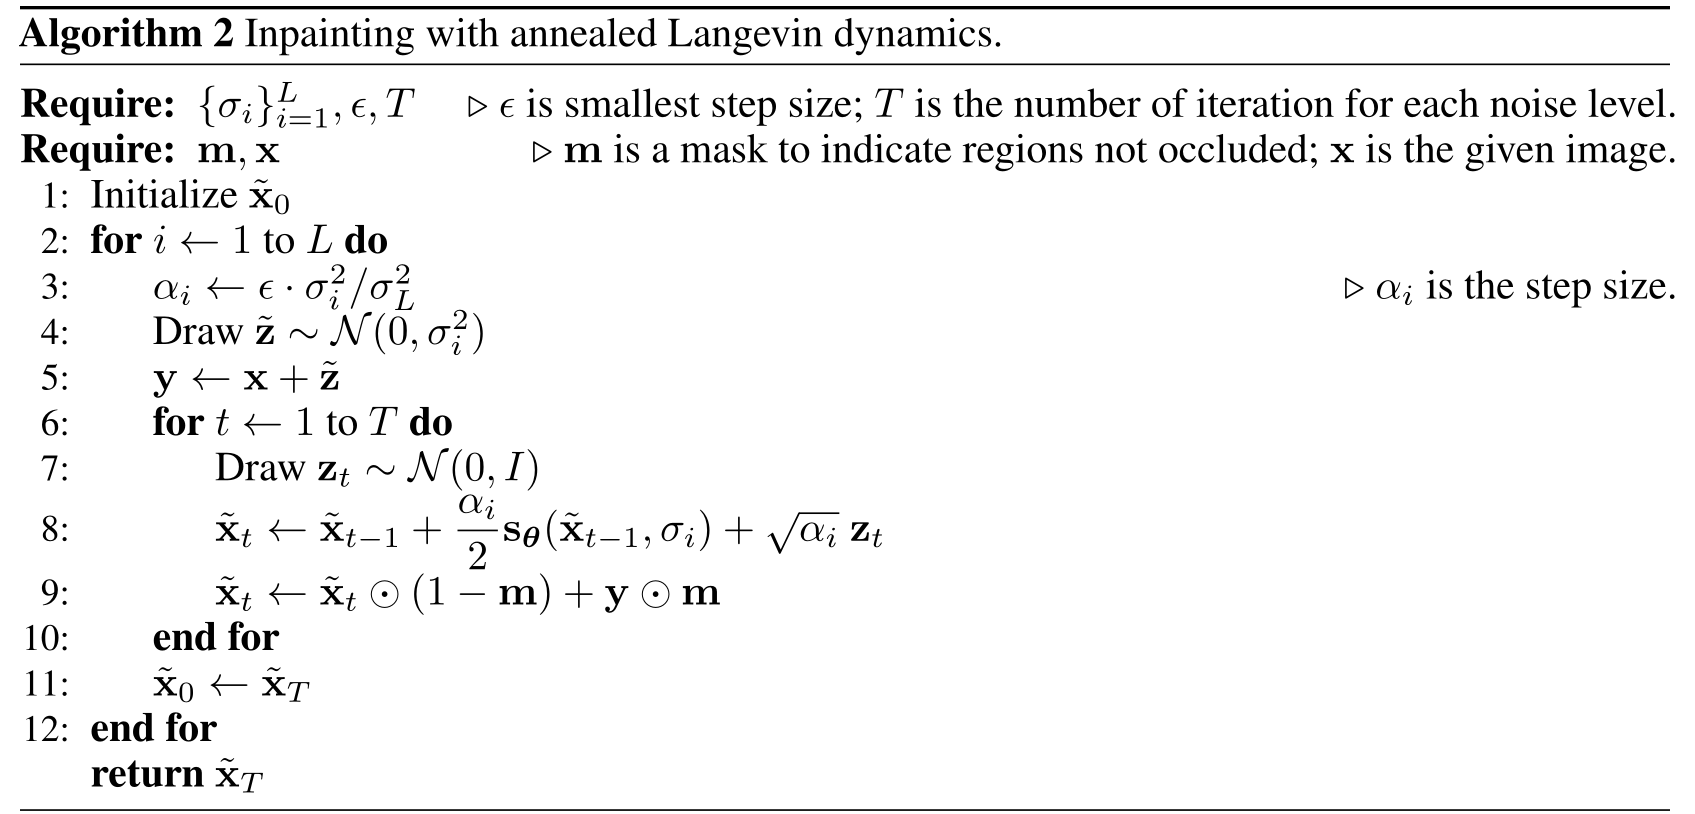
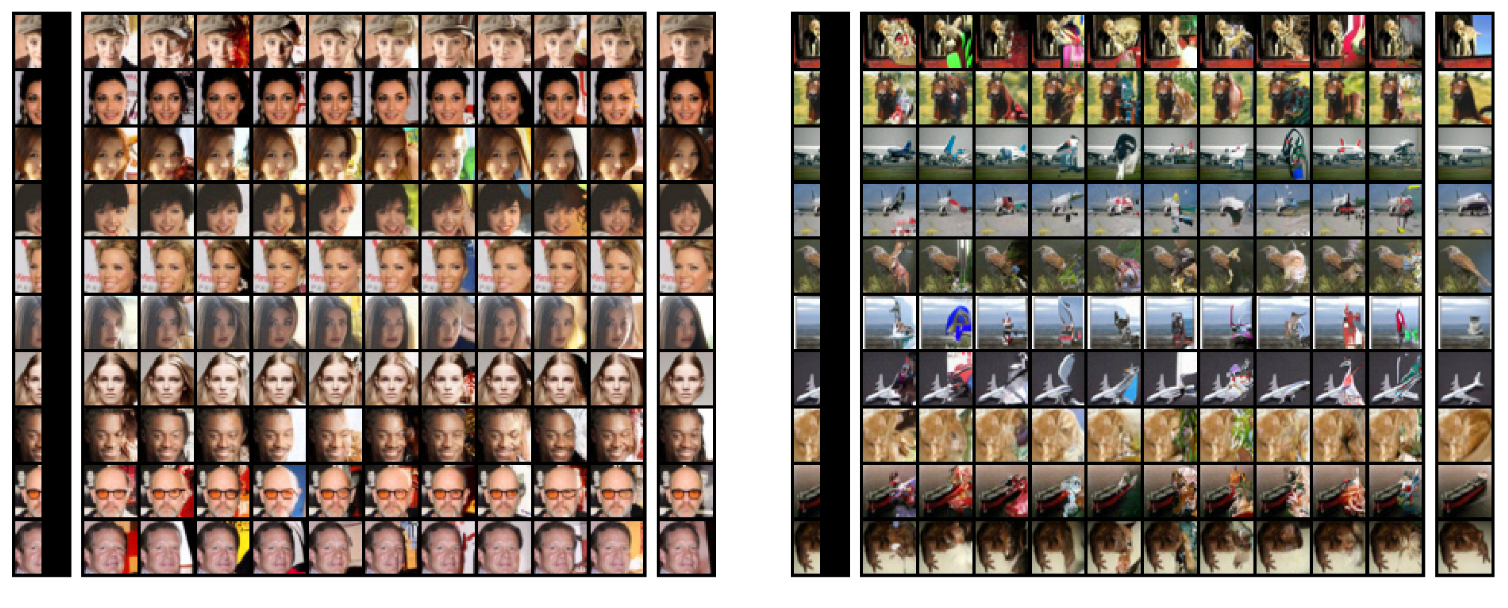
图像修复(inpainting)。 由于方法能处理任意形状遮挡,修复只需对退火 Langevin 做简单修改(附录 B.3 / 算法 2):用掩码 $m$ 标记已知像素,在每个水平上对给定图像重新加噪,并在每次 Langevin 步后把已知像素写回。这利用了分数网络学到的表示。与只能按光栅扫描顺序补全的 PixelCNN 不同,NCSN 可处理任意形状;结果见图 6 与附录 C.5。
相关工作
论文把自己与先前的马尔可夫链转移算子学习器相对照。生成随机网络(GSN) 用去噪自编码器训练一个平衡分布匹配数据的链,但常从训练点附近起始、需要模态间快速转移,而 NCSN 从无结构噪声退火。非平衡热力学(NET) 反转一个预设扩散过程,但因需要极小扩散步与训练时上千步的链模拟而不易扩展。注入训练(infusion training) 与 变分回走(variational walkback) 使用多噪声水平/温度,但以最大化 ELBO 训练,样本偏模糊、类似 VAE。关键结构性差异是:(i) NCSN 在训练时无需采样马尔可夫链(不同于回走的负样本或 NET/IT/VW),因而更易扩展;(ii) 训练与采样解耦——任意分数估计器(切片或 DSM)可与任意基于分数的采样器(Langevin,乃至 HMC)组合;(iii) NCSN 可通过把 EBM 的梯度作为分数模型来训练基于能量的模型。论文还指出,历史上面向 EBM 的分数匹配要么不可扩展、要么样本质量差;对比散度把 Langevin 作为昂贵的训练内循环;以及“退火 + 去噪”曾在表示学习语境中出现,但未用于生成建模。
结论
SMLD 将其贡献总结为一个框架:通过分数匹配估计数据密度的梯度、通过 Langevin 动力学生成样本;它分析了朴素版本的障碍,并用噪声条件分数网络加退火 Langevin 动力学予以解决,且不要求对抗训练、训练时 MCMC 或特殊架构。实验表明其图像质量此前仅见于最好的似然模型与 GAN,且取得了新的 CIFAR-10 Inception 分数纪录、FID 与 SNGAN 相当。
附录小结(SMLD A–C)
- A. 架构: 三个组件。实例归一化扩展为条件形式,使缩放/偏置依赖 $\sigma_i$;由于普通实例归一会丢弃各通道均值(导致颜色偏移),作者加入可学习修 正, 即 “CondInstanceNorm++”:$z_k = \gamma[i,k]\frac{x_{k}-\mu_{k}}{s_{k}} + \beta[i,k]+ \alpha[i,k]\frac{\mu_{k}-m}{v}$, 其中 $m,v$ 是各 $\mu_k$ 的均值/标准差。空洞卷积在保持分辨率的同时扩大感受 野,替换除第一层外的全部下采样。U-Net/RefineNet: 4 级级联 RefineNet,预激 活残差块,移除批归一化并换为 CondInstanceNorm++,用平均池化替代最大池化,ELU 激活,逐级将膨胀加倍;第一级卷积核数 128(后续加倍)用于 CelebA/CIFAR-10,MNIST 上减半。
- B. 细节: CIFAR-10 上的 SSM ResNet 玩具实验(编码器 5 个残差块,Adam,lr 1e-3,批 128,5 万次迭代);玩具 MLP(3 层、128 单元、softplus);玩具 Langevin($T = 1000$、$\epsilon = 0.1$)与退火 ($T = 100$、$L = 10$、$\epsilon = 0.1$、$\sigma_1 = 20 \to \sigma_{10} = 1$); 图像生成(Adam lr 1e-3、20 万次迭代、批 128、以 1000 张样本的 FID 选检查点、在 5 万张样本上计算分数);修复算法 2。
- C. 样本: 基线样本(C.1)、像素与 Inception 特征空间的近邻(C.2)、扩展样 本(C.3)、退火 Langevin 中间样本(C.4)、扩展修复结果(C.5)。
DDPM
DDPM 开篇观察到,各类深度生成模型,GAN、自回归模型、流、VAE,如今都能产生高质量样本,基于能量/分数匹配的方法也已追上 GAN。论文随后推进扩散概率模型(沿用 Sohl-Dickstein 等):一个用变分推断训练的、参数化的马尔可夫链,在有限时间后产生与数据匹配的样本;它模拟一个用高斯噪声逐渐破坏信号的扩散链路的反转过程。由于噪声小且为高斯,其逆向转移也可取高斯形式,从而给出非常简单的神经网络参数化。
作者直陈领域现状:扩散模型易于定义、训练高效,但此前未被证明能生成高质量样本。这片论文的贡献在于:证明它们可以,且有时胜过其它模型类已发表的结果;证明某种特定参数化揭示了训练时与多噪声水平上的去噪分数匹配、采样时与退火 Langevin 动力学的等价性;并证明采样过程是一种渐进式有损解压、推广了自回归解码。作者指出:它们所提出的模型在似然上不具竞争力,且大部分无损码长花在了不可感知的细节上。
背景
扩散模型是隐变量模型($x_{1:T}$ 是隐变量,$p_\theta(x_0)$ 是联合分布的边缘概率)
$$ p_\theta(x_0): = \int p_\theta(x_{0:T}), dx_{1:T}, $$
其中 $x_1,\dots,x_T$ 与 $x_0 \sim q(x_0)$ 同维。逆向过程是从 $p(x_T)= \mathcal{N}(x_T;0,I)$ 出发的学习到的高斯马尔可夫链(这是去噪过程,目标是要学习 $\mu_\theta$ 和 $\Sigma_\theta$):
$$ p_\theta(x_{0:T}): = p(x_T)\prod_{t=1}^T p_\theta(x_{t-1} \mid x_t),\qquad p_ \theta(x_{t-1} \mid x_t)= \mathcal{N}(x_{t-1};\mu_\theta(x_t,t),\Sigma_\theta(x_ t,t)). $$
前验:已知隐变量,推断观测;后验:已知观测,推断隐变量。
扩散模型区别于其它隐变量模型之处在于:前向过程(在 DDPM 中,扩散 $\approx$ 前向 $\approx$ 后验)被固定为一个按方差表 $\beta_1,\dots,\beta_T$ 逐次加入高斯噪声的马尔可夫链(这是加噪过程):
$$ q(x_{1:T} \mid x_0): = \prod_{t=1}^T q(x_t \mid x_{t-1}),\qquad q(x_t \mid x_ {t-1}): = \mathcal{N}(x_t;\sqrt{1-\beta_{t}} , x_{t-1},\beta_t I). $$
Jesen 不等式:期望的凹函数大于等于凹函数的期望,凸函数相反,同时适用于离散和积分形式
训练最小化负对数似然的变分界(ELBO,其中 $\mathbb{E}_q = \mathbb{E}_{x_0} \mathbb{E}_{q(x_{1:T}\mid x_0)}$,且 $-\log$ 为凸函数,所以 Jensen 给出 $\le$):
$$ \begin{aligned} \mathbb{E}[- \log p_\theta(x_0)] & = \mathbb{E}_{x_0}[- \log \int q(x_{1:T} \mid x_0)\frac{p_{\theta}(x_{0:T})}{q(x_{1:T}\mid x_{0})} , dx_{1:T}]\\ & = \mathbb{E}_{x_0}[- \log \mathbb{E}_{q(x_{1:T}\mid x_0)}[\frac{p_{\theta}(x_{0:T})}{q(x_{1:T}\mid x_{0})}]]\\ & \le \mathbb{E}_{x_0} \mathbb{E}_{q(x_{1:T}\mid x_0)}[- \log \frac{p_{\theta}(x_{0:T})}{q(x_{1:T}\mid x_{0})}]\\ & = \mathbb{E}_q[- \log \frac{p_{\theta}(x_{0:T})}{q(x_{1:T}\mid x_{0})}]\\ & = \mathbb{E}_q[- \log p_\theta(x_{0:T})+ \log q(x_{1:T} \mid x_0)]\\ & = \mathbb{E}_q[- \log(p_\theta(x_T)\prod_{t=1}^T p_\theta(x_{t-1} \mid x_t))+ \log(\prod_{t=1}^T q(x_t \mid x_{t-1}))]\\ & = \mathbb{E}_q[- \log p_\theta(x_T)- \sum_{t=1}^T \log p_\theta(x_{t-1} \mid x_t)+ \sum_{t=1}^T \log q(x_t \mid x_{t-1})]\\ & = \mathbb{E}_q[- \log p_\theta(x_T)- \sum_{t=1}^T \log \frac{p_{\theta}(x_{t-1}\mid x_{t})}{q(x_{t}\mid x_{t-1})}]\\ & = \mathbb{E}_q[- \log p_\theta(x_T)- \sum_{t\ge1} \log \frac{p_{\theta}(x_{t-1}\mid x_{t})}{q(x_{t}\mid x_{t-1})}]= : \mathcal{L} . \end{aligned} $$
上述推导对应的就是原文公式:
$$ \begin{aligned} \mathbb{E}[- \log p_\theta(x_0)]& \le \mathbb{E}_q[- \log \frac{p_{\theta}(x_{0:T})}{q(x_{1:T}\mid x_{0})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t\ge1} \log \frac{p_{\theta}(x_{t-1}\mid x_{t})}{q(x_{t}\mid x_{t-1})}]= : \mathcal{L} \end{aligned} \tag{DDPM 式 3} $$
方差 $\beta_t$ 可通过重参数化学习,也可作为超参数固定,DDPM 选取了后者;当 $\beta_t$ 较小时,高斯条件项保证逆向与前向具有相同的函数形式 (这里的意思是,整个逆向去噪的过程也可以看成若干连续的高斯扰动) 关键的是,前向过程在任意 $t$ 都有闭式边缘分布。记 $\alpha_t : = 1 - \beta_t$、$\bar \alpha_t : = \prod_{s=1}^t \alpha_s$,则
$$ q(x_t \mid x_0)= \mathcal{N}(x_t;\sqrt{\bar\alpha_{t}} , x_0,(1 - \bar \alpha_t )I). \tag{DDPM 式 4} $$
因此高效训练可用 $\mathcal{L}$ 的随机项,并通过重写为 KL 散度之和来降低方差(也就是将“需要采样完整时间序列”的高方差联合期望,化简成了“只需单步采样并计算 MSE”的低方差形式,从而消除了多步随机噪声的累积):
$$ \begin{aligned} \mathcal{L} & = \mathbb{E}_q \Big[\underbrace{D_{\mathrm{KL}}\left(q(x_T\mid x_0),|,p(x_T)\right)}_{\mathcal{L}_T} \\ & + \sum_{t>1} \underbrace{D_{\mathrm{KL}}\left(q(x_{t-1}\mid x_t,x_0),|,p_\theta(x_{t-1}\mid x_t)\right)}_{\mathcal{L}_{t-1}} \\ & - \underbrace{\log p_\theta(x_0\mid x_1)}_{\mathcal{L}_0} \Big]. \end{aligned} \tag{DDPM 式 5} $$
直观理解这个公式:它由三个部分组成,目标是减少真实分布与模型预测分布之间的差异。具体来说:
- $\mathcal{L}_T$(先验匹配项):减少真实前向最终分布 $q(x_T|x_0)$ 与标准高 斯先验 $p(x_T)$ 的差异。 (让最终噪声彻底变成标准正态分布)
- $\mathcal{L}_{t-1}$(去噪匹配项):减少真实后验分布 $q(x_{t-1} |x_t,x_0)$ 与模型预测的反向分布 $p_\theta(x_{t-1} |x_t)$ 的差异。 (让模型学会每一步如 何准确去除噪声)
- $\mathcal{L}_0$(重建项):减少从 $x_1$ 恢复 $x_0$ 时的重构误差。 (确保 最后能生成清晰的原图)
以下是 DDPM 式 5 的完整推导流程:
$$ \begin{aligned} \mathcal{L} & = \mathbb{E}_q[- \log \frac{p_{\theta}(x_{0:T})}{q(x_{1:T}|x_{0})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t\ge1} \log \frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t}|x_{t-1})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t>1} \log \frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t}|x_{t-1})} - \log \frac{p_{\theta}(x_{0}|x_{1})}{q(x_{1}|x_{0})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t>1} \log(\frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t-1}|x_{t}, x_{0})} \cdot \frac{q(x_{t-1}|x_{0})}{q(x_{t}|x_{0})})- \log \frac{p_{\theta}(x_{0}|x_{1})}{q(x_{1}|x_{0})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t>1} \log \frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t-1}|x_{t}, x_{0})} - \sum_{t>1}(\log q(x_{t-1} |x_0)- \log q(x_t|x_0))- \log \frac{p_{\theta}(x_{0}|x_{1})}{q(x_{1}|x_{0})}]\\ & = \mathbb{E}_q[- \log p(x_T)- \sum_{t>1} \log \frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t-1}|x_{t}, x_{0})} -(\log q(x_1 | x_0)- \log q(x_T | x_0))- \log \frac{p_{\theta}(x_{0}|x_{1})}{q(x_{1}|x_{0})}]\\ & = \mathbb{E}_q[- \log \frac{p(x_{T})}{q(x_{T}|x_{0})} - \sum_{t>1} \log \frac{p_{\theta}(x_{t-1}|x_{t})}{q(x_{t-1}|x_{t}, x_{0})} - \log p_\theta(x_0|x_1)]\\ & = \mathbb{E}_q[D_{\text{KL}}(q(x_T|x_0)| p(x_T))+ \sum_{t>1} D_{\text{KL}}(q(x_{t-1} |x_t,x_0)| p_\theta(x_{t-1} |x_t))- \log p_\theta(x_0|x_1)] \end{aligned} $$
该比较之所以可处理,是因为以 $x_0$ 为条件的前向后验(也即 $q(x_{t-1} |x_t,x_0)$)是高斯:
$$ q(x_{t-1} \mid x_t,x_0)= \mathcal{N}(x_{t-1};\tilde \mu_t(x_t,x_0),\tilde \beta_ t I),\tag{DDPM 式 6} $$
$$ \tilde \mu_t(x_t,x_0): = \frac{\sqrt{\bar\alpha_{t-1}},\beta_{t}} {1-\bar\alpha_{t}} x_0 + \frac{\sqrt{\alpha_t},(1-\bar\alpha_{t-1})} {1-\bar\alpha_{t}} x_t,\qquad \tilde \beta_t : = \frac{1-\bar\alpha_{t-1}} {1-\bar\alpha_{t}} \beta_t . \tag{DDPM 式 7} $$
目标是学习 $\mu_\theta(x_t,t)$ 和 $\Sigma_\theta(x_t,t)$,让其接近真实的 $\tilde \mu_t(x_t,x_0)$ 和 $\tilde \beta_t$。由于所有 KL 项都是高斯之间的比较,可用 Rao–Blackwell 化的闭式表达,从而无须高方差的蒙特卡洛估计(SMLD:点我呢?)。从上面的参数化形式来看,只需要采样 $x_0$ 和 $x_t$。两个多元正态分布($x \in \mathbb{R}^b$)的 KL 散度的解析形式是:
$$ D_{\mathrm{KL}}(p | q)= \frac{1}{2} [\operatorname{tr}(\Sigma_2^{-1} \Sigma_1)+(\mu_2 - \mu_1)^\top \Sigma_2^{-1}(\mu_2 - \mu_1)- d + \log \frac{\det\Sigma_{2}}{\det\Sigma_{1}}] $$
扩散模型与去噪自编码器
本节通过建立扩散模型与去噪分数匹配之间的显式联系来指导设计选择,并按照式 5 的各项组织讨论。
前向过程与 $\mathcal{L}_T$
作者放弃通过重参数化学习 $\beta_t$ 的做法,改为固定为常数,于是近似后验 $q$ 无可学习参数,$\mathcal{L}_T$ 在训练中是常数、可以直接忽略。
逆向过程与 $\mathcal{L}_{1:T-1}$
对 $1 < t \le T$,取 $p_\theta(x_{t-1} \mid x_t)= \mathcal{N}(x_{t-1};\mu_\theta(x_t,t),\Sigma_\theta(x_t,t))$,其中 $\Sigma_\theta(x_t,t)= \sigma_t^2 I$ (通道独立假设)为未经训练、随时间变化的常数。实验上 $\sigma_t^2 = \beta_t$ 与 $\sigma_t^2 = \tilde \beta_t$ 结果相近;前者对 $x_0 \sim \mathcal{N}(0,I)$ 最优,后者对确定性 $x_0$ 最优,分别对应对单位方差数据逆向过程熵的上、下界。在此选择下,$\mathcal{L}_{t-1}$ 的解析形式是:
$$ \mathcal{L}_{t-1} = \mathbb{E}_q [\frac{1}{2\sigma_{t}^{2}} | \tilde \mu_t(x_t,x_0)- \mu_\theta(x_t,t)|^2]+ C, \tag{DDPM 式 8} $$
其中 $C$ 与 $\theta$ 无关:最直接的参数化就是预测前向后验均值 $\tilde \mu_t$。借助重参数化
$$ x_t(x_0,\epsilon)= \sqrt{\bar\alpha_{t}} , x_0 + \sqrt{1-\bar\alpha_{t}} , \epsilon,\qquad \epsilon \sim \mathcal{N}(0,I),\tag{DDPM 式 9} $$
并代入式 7 得(其中用到 $\bar \alpha_t = \alpha_t \bar \alpha_{t-1}$,$\beta_t = 1 - \alpha_t$)
$$ \begin{aligned} \tilde \mu_t(x_t,x_0) & : = \frac{\sqrt{\bar\alpha_{t-1}},\beta_{t}}{1-\bar\alpha_{t}} x_0 + \frac{\sqrt{\alpha_t},(1-\bar\alpha_{t-1})}{1-\bar\alpha_{t}} x_t \\ & = \frac{\sqrt{\bar\alpha_{t-1}},\beta_{t}}{1-\bar\alpha_{t}} \cdot \frac{x_{t}-\sqrt{1-\bar\alpha_t},\epsilon}{\sqrt{\bar\alpha_{t}}} \quad + \frac{\sqrt{\alpha_t},(1-\bar\alpha_{t-1})}{1-\bar\alpha_{t}} x_t \\ & = \frac{\beta_{t}}{(1-\bar\alpha_{t})\sqrt{\alpha_t}} \bigl(x_t - \sqrt{1-\bar\alpha_{t}} , \epsilon \bigr)+ \frac{\sqrt{\alpha_t},(1-\bar\alpha_{t-1})}{1-\bar\alpha_{t}} x_t \\ & =[\frac{\beta_{t}}{(1-\bar\alpha_{t})\sqrt{\alpha_t}} + \frac{\sqrt{\alpha_t},(1-\bar\alpha_{t-1})}{1-\bar\alpha_{t}}]x_t - \frac{\beta_{t}}{\sqrt{\alpha_{t}(1-\bar\alpha_{t})}} , \epsilon \\ & = \frac{1}{\sqrt{\alpha_{t}}} x_t - \frac{\beta_{t}}{\sqrt{\alpha_{t}(1-\bar\alpha_{t})}} , \epsilon \\ & = \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} , \epsilon). \end{aligned} $$
从而得到
$$ \mathcal{L}_{t-1} - C = \mathbb{E}_{x_0,\epsilon} [\frac{1}{2\sigma_{t}^{2}} | \frac{1}{\sqrt{\alpha_{t}}}(x_t(x_0,\epsilon)- \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon)- \mu_\theta(x_t(x_0,\epsilon),t)|^2] . \tag{DDPM 式 10} $$
这个式子仍然有点复杂,为了更进一步地简化,我们会让预测均值 $\mu_\theta$ 具有和目标均值 $\tilde \mu_t$ 相同的形式。也即 $\mu_\theta$ 必须在给定 $x_t$ 时预测 $\frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon)$。那不如引入一个预测所注入噪声的网络 $\epsilon_\theta$,这样一来:
$$ \mu_\theta(x_t,t)= \tilde \mu_t(x_t,\frac{1}{\sqrt{\bar\alpha_{t}}}(x_t - \sqrt {1-\bar\alpha_{t}} , \epsilon_\theta(x_t,t)))= \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon_\theta(x_t,t)). $$
这个时候我们会发现:如果把式 11 带入式 10 中,$x_t$ 会完全消掉,这就是我们选择预测噪声,而不是直接预测均值的原因,它可以进一步减少系统误差。以上从式 8 到式 11 的推导,可以用一条简单主线描述:取消预测方差 $\rightarrow$ 将 $x_0$ 移出 $\tilde \mu_t$ $\rightarrow$ 从预测后验均值转向预测后验噪声。于是从 $p_\theta(x_{t-1} \mid x_t)$ 采样变为
$$ x_{t-1} = \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}} {\sqrt{1-\bar\alpha_{t}}} \epsilon_\theta(x_t,t))+ \sigma_t z,\qquad z \sim \mathcal{N}(0,I). \tag{DDPM 式 11} $$
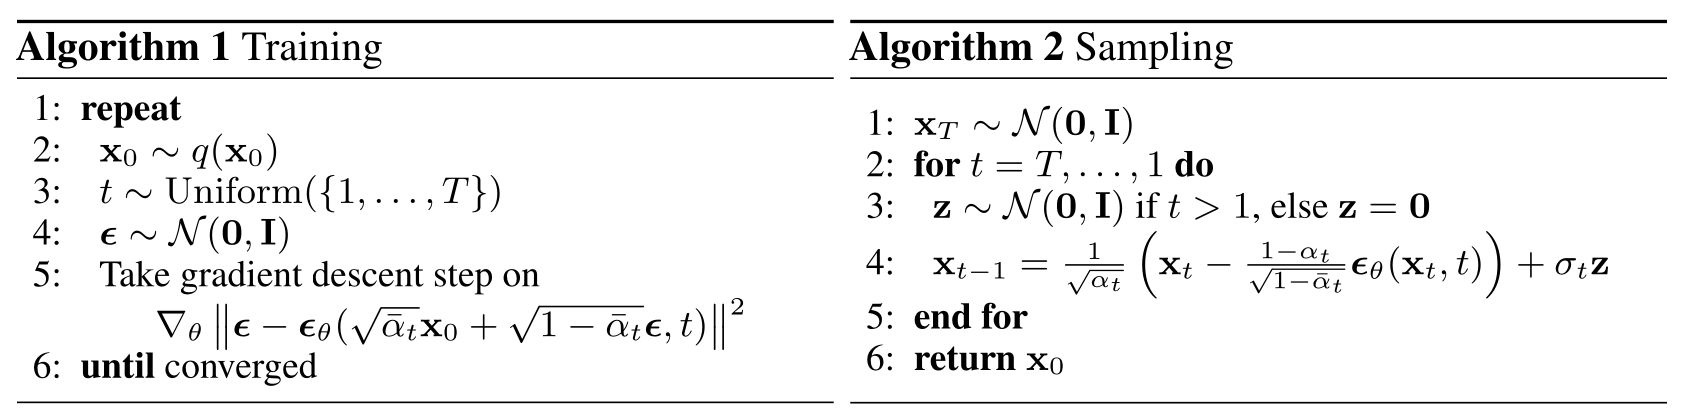
完整的采样过程在算法 2 中给出,论文指出它类似 Langevin 动力学,其中 $\epsilon_\theta$ 充当学习到的数据密度对数梯度(详情参考下一节)。在式 11 下,式 10 简化为
$$ \begin{aligned} \mathcal{L}_{t-1} - C & = \mathbb{E}_{x_0,\epsilon}[\frac{1}{2\sigma_{t}^{2}} | \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon)- \mu_\theta(x_t,t)|^2]\\ & = \mathbb{E}_{x_0,\epsilon}[\frac{1}{2\sigma_{t}^{2}} | \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon)- \frac{1}{\sqrt{\alpha_{t}}}(x_t - \frac{\beta_{t}}{\sqrt{1-\bar\alpha_{t}}} \epsilon_\theta(x_t,t))|^2]\\ & = \mathbb{E}_{x_0,\epsilon}[\frac{1}{2\sigma_{t}^{2}} | \frac{\beta_{t}}{\sqrt{\alpha_{t}(1-\bar\alpha_{t})}}(\epsilon_\theta(x_t,t)- \epsilon)|^2]\\ & = \mathbb{E}_{x_0,\epsilon}[\frac{\beta_{t}^{2}}{2\sigma_{t}^{2}\alpha_{t}(1-\bar\alpha_{t})} | \epsilon - \epsilon_\theta(\sqrt{\bar\alpha_{t}} x_0 + \sqrt{1-\bar\alpha_{t}} \epsilon,, t)|^2]. \end{aligned} $$
也就是
$$ \mathcal{L}_{t-1} - C = \mathbb{E}_{x_0,\epsilon} [\frac{\beta_{t}^{2}}{2\sigma_{t}^{2}\alpha_{t}(1-\bar\alpha_{t})} | \epsilon - \epsilon_\theta(\sqrt{\bar\alpha_{t}} x_0 + \sqrt{1-\bar\alpha_{t}} \epsilon,, t)|^2] . \tag{DDPM 式 12} $$
与 Langevin 动力学采样的关联
式 11 的损失类似于以 $t$ 为索引的多噪声尺度去噪分数噪声匹配(DSM)。由式 4 (任意 $t$ 时刻的边缘闭式分布)和式 9 ($x_t$ 的重参数化)可得 $t$ 时刻的分数(密度对数梯度)为
$$ \nabla_{x_t} \log q(x_t | x_0)= - \frac{x_{t}- \sqrt{\bar \alpha_t}x_{0}} {1 - \bar \alpha_{t}} = - \frac{\epsilon}{\sqrt{1 - \bar \alpha_{t}}} $$
在这个意义上,不难看出 $\epsilon_\theta$ 即与分数估计 $s_\theta$ 只相差 1 个与 $t$ 有关的确定缩放。而式 11 给出的采样方式和 Langevin 动力学类似,具体地,式 10 可写为:
$$ \begin{aligned} \mathcal{L}_{t-1} - C & = \mathbb{E}_{x_0,\epsilon}[\frac{\beta_{t}^{2}}{2\sigma_{t}^{2}\alpha_{t}(1-\bar\alpha_{t})} | \epsilon - \epsilon_\theta(x_t,t)|^2]\\ & = \frac{\beta_{t}^{2}}{\sigma_{t}^{2}\alpha_{t}} \cdot \frac{1}{2} \mathbb{E}_{x_0,\epsilon}[| s_\theta(x_t,t)+ \frac{\epsilon}{\sqrt{1-\bar\alpha_{t}}} |^2]\\ & = \frac{\beta_{t}^{2}}{\sigma_{t}^{2}\alpha_{t}} , \ell_{\mathrm{DSM}}(\theta;t), \end{aligned} $$
其中
$$ \ell_{\mathrm{DSM}}(\theta;t)= \frac{1}{2} \mathbb{E}_{x_0,\epsilon} [| s_\theta(x_t,t)+ \frac{\epsilon}{\sqrt{1-\bar\alpha_{t}}} |^2]= \frac{1} {2(1-\bar\alpha_{t})} \mathbb{E}_{x_0,\epsilon} [| \epsilon - \epsilon_\theta(x_t,t)|^2]. $$
所以 DDPM 的损失,即是 以 $t$ 为索引的多噪声尺度 DSM 损失的加权版本。与此同时,式 11 的采样更新与 Langevin 更新同型:漂移项由分数 $s_\theta$ 驱动,噪声项为高斯,步长由 $\beta_t$ 控制。因此, SMLD 与 DDPM 在这一点上达成了一致。
数据缩放、逆向过程解码器与 $L_0$
是 ${0,\dots,255}$ 的整数,被线性缩放到 $[- 1,1]$,从而逆向网络在由标准正态先验出发的一致尺度上工作。为得到离散对数似然,最后一项逆向过程被设为由高斯 $\mathcal{N}(x_0;\mu_\theta(x_1,1),\sigma_1^2 I)$ 导出的独立离散解码器:
$$ p_\theta(x_0 \mid x_1)= \prod_{i=1}^D \int_{\delta_-(x_0^i)}^{\delta_+(x_0^i)} \mathcal{N}(x;\mu_\theta^i(x_1,1),\sigma_1^2), dx,\tag{DDPM 式 13} $$
$$ \delta_+(x)= \begin{cases}\infty & x=1\ x+\tfrac{1}{255} & x<1\end{cases},\qquad \delta_-(x)= \begin{cases}-\infty & x=-1\ x-\tfrac{1}{255} & x>-1\end{cases} . $$
式 13 的目标是为了将离散的图像数据变成连续空间中的分布。这与 VAE/自回归解码器所用的离散化连续分布类似,保证变分界是离散数据的无损码长,且不需要向数据加噪或引入缩放运算的雅可比;采样结束时直接输出无噪声的 $\mu_\theta(x_1,1)$,然后利用 $p_\theta(x_0 | x_1)$ 采样得到最终生成的图像。
简化训练目标
虽然完整变分界可微,作者却训练一个既提升样本质量、又更易实现的变体(等于说之前花费精力推出的 $\mathcal{L}$ 在这里被取缔了):
$$ \mathcal{L}_{\text{completed}} : = \mathcal{L}_T + \sum_{t>1} \mathcal{L}_{t-1} + \mathcal{L}_0 \qquad \text{谁来替我发声!🤬} $$
$$ \mathcal{L}_{\text{simple}}(\theta): = \mathbb{E}_{t,x_0,\epsilon} [| \epsilon - \epsilon_\theta(\sqrt{\bar\alpha_{t}} x_0 + \sqrt{1-\bar\alpha_{t}} \epsilon,, t)|^2] ,\tag{DDPM 式 14} $$
其中 $t$ 在 $1,\dots,T$ 上均匀。$t = 1$ 的情形对应 $\mathcal{L}_0$,即用高斯概率密度乘以区间宽度近似式 13 的积分(忽略 $\sigma_1^2$ 与边界效应);$t > 1$ 的情形是式 12 的未加权版本,类似于 NCSN 所用的损失加权。由于式 14 丢弃了式 12 的权重,它是一个强调不同重建侧面的重加权变分界;在其设置下,该重加权下调小 $t$ 项(这些项只在极小噪声下去噪),使网络专注于更困难的大 $t$ 去噪。算法 1 给出训练循环。
实验
所有实验取 $T = 1000$(与先前工作的网络评估次数一致),前向方差为常数且从 $\beta_1 = 10^{-4}$ 线性增至 $\beta_T = 0.02$;相对 $[- 1,1]$ 数据而言这些常数很小,使前向与逆向近似同形,同时把终端信噪比压到极低($\mathcal{L}_T \approx 10^{-5}$ 比特/维度)。逆向过程使用类似未掩码 PixelCNN++ 的 U-Net,全程用组归一化,参数跨时间共享,用 Transformer 正弦位置嵌入指定时间,并在 $16 \times 16$ 特征分辨率上使用自注意力。
样本质量
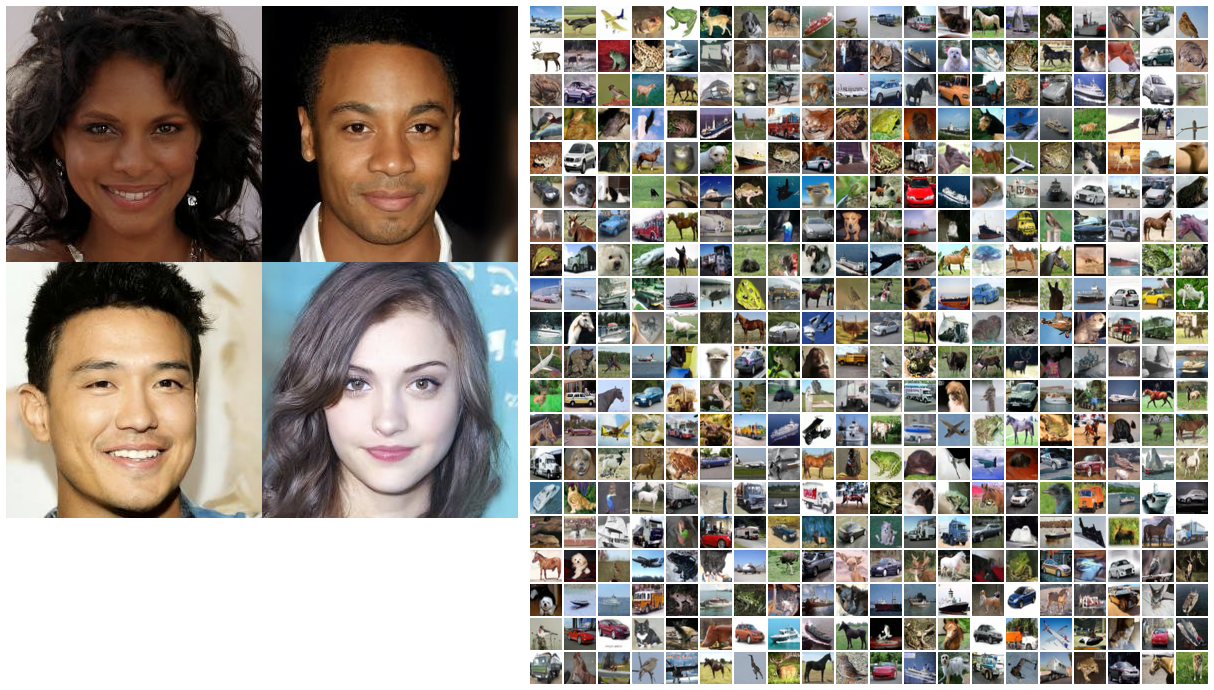
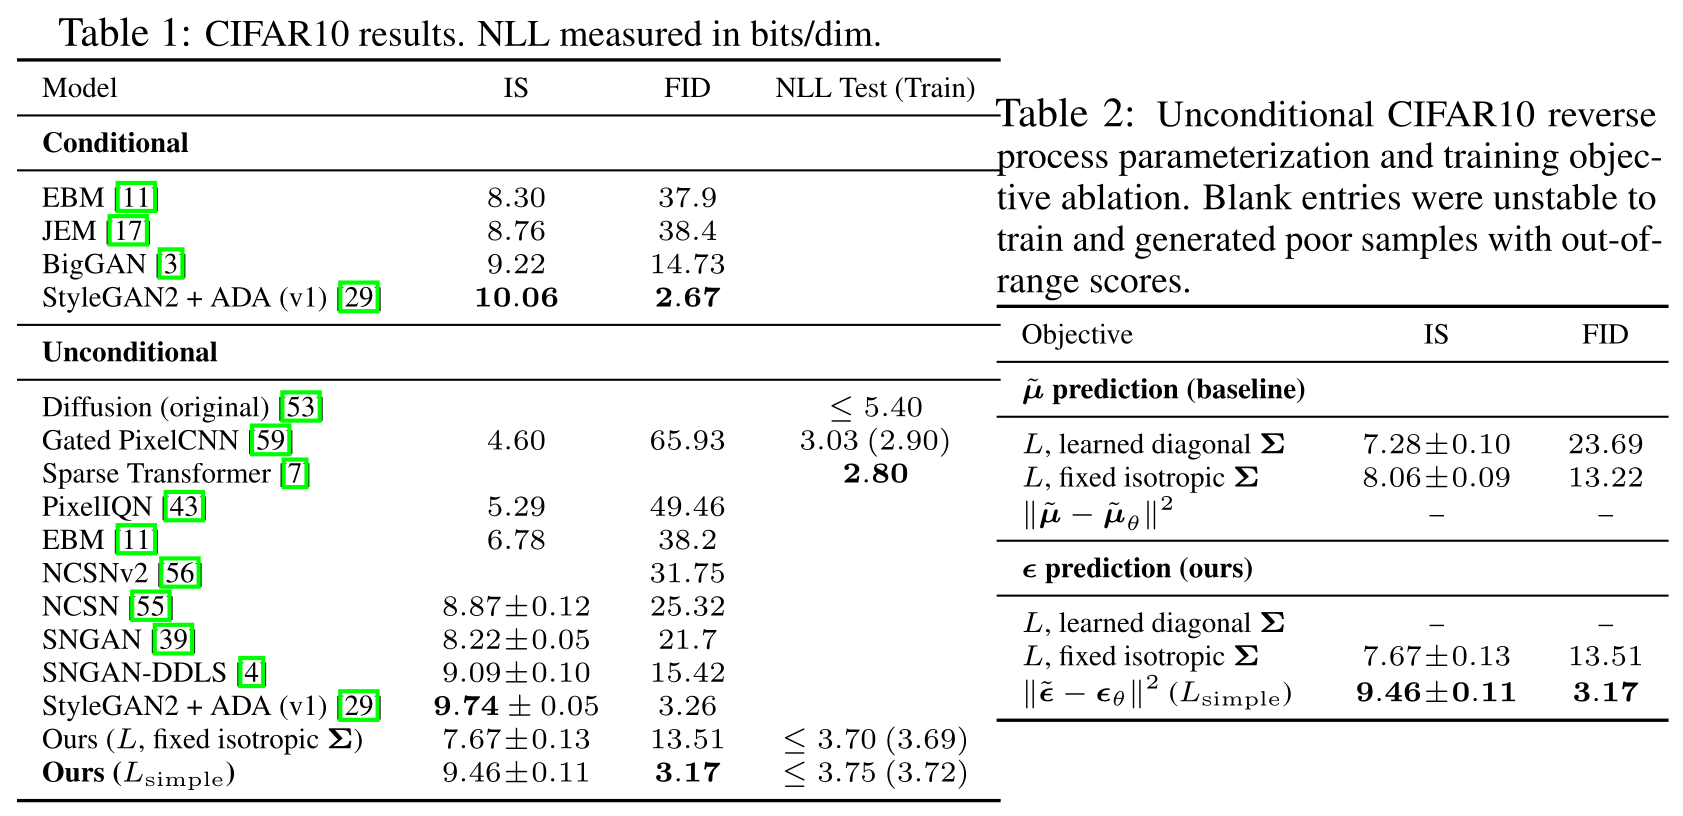
在 CIFAR-10(表 1)上,无条件的 $\mathcal{L}_{\text{simple}}$ 模型达到 Inception 9.46 ± 0.11、FID 3.17,优于多数已发表模型(含类条件模型)。(按惯例 FID 相对训练集计算;相对测试集为 5.24,仍具竞争力。)真变分界模型($\mathcal{L}$,固定各向同性 $\Sigma$)为 IS 7.67、FID 13.51,但 NLL 更好($\le 3.70$)。基线包括 Gated PixelCNN(4.60 / 65.93 / NLL 3.03)、NCSN(8.87 / 25.32)、SNGAN(8.22 / 21.7)、SNGAN-DDLS(9.09 / 15.42)、StyleGAN2+ADA(9.74 / 3.26),以及类条件 BigGAN(9.22 / 14.73)。在 $256 \times 256$ LSUN 上报告 FID 7.89(Church)、4.90(Bedroom,大模型)、6.36(Bedroom,小模型)、19.75(Cat),对照 ProgressiveGAN 8.34 / 6.42 / 37.52、StyleGAN2 –/3.86/6.93。结论是:在真变分界上训练能获得更好的码长,但简化目标带来最好的样本质量。这由直接比较(表 1)及下述消融确认。
逆向过程参数化与训练目标消融
表 2 分离出两个维度:(i) 参数化($\tilde \mu$ 对 $\epsilon$);(ii) 训练目标(带可学习对角 $\Sigma$ 的 $\mathcal{L}$、带固定各向同性 $\Sigma$ 的 $\mathcal{L}$、或 $\mathcal{L}_{\text{simple}}$)。结果:预测 $\tilde \mu$ 只在真变分界下有效(IS 8.06 / FID 13.22),在未加权 MSE 下不稳定($-$);可学习对角 $\Sigma$ 不稳定/更差;预测 $\epsilon$ 在真变分界加固定方差下与 $\tilde \mu$ 相当(7.67 / 13.51),但在简化目标下显著胜出(9.46 / 3.17)。这通过受控消融确认:正是这个类 DSM 的重加权目标解锁了高质量样本。
渐进编码
何为码长? 码长是用模型分布对样本做最优编码的平均比特数,约 $-\log_2 p_\theta(x_0)$;扩散模型用负 ELBO $\mathcal{L}$ 作代理,按 $\mathcal{L} /(D \ln 2)$ 换算成“比特/维度”($D$ 是图像维度)。DDPM 中 $\mathcal{L}_1 + \dots + \mathcal{L}_T$ 被视为码率,$\mathcal{L}_0$ 被视为失真,所以表 1 的码长就是总无损码长。
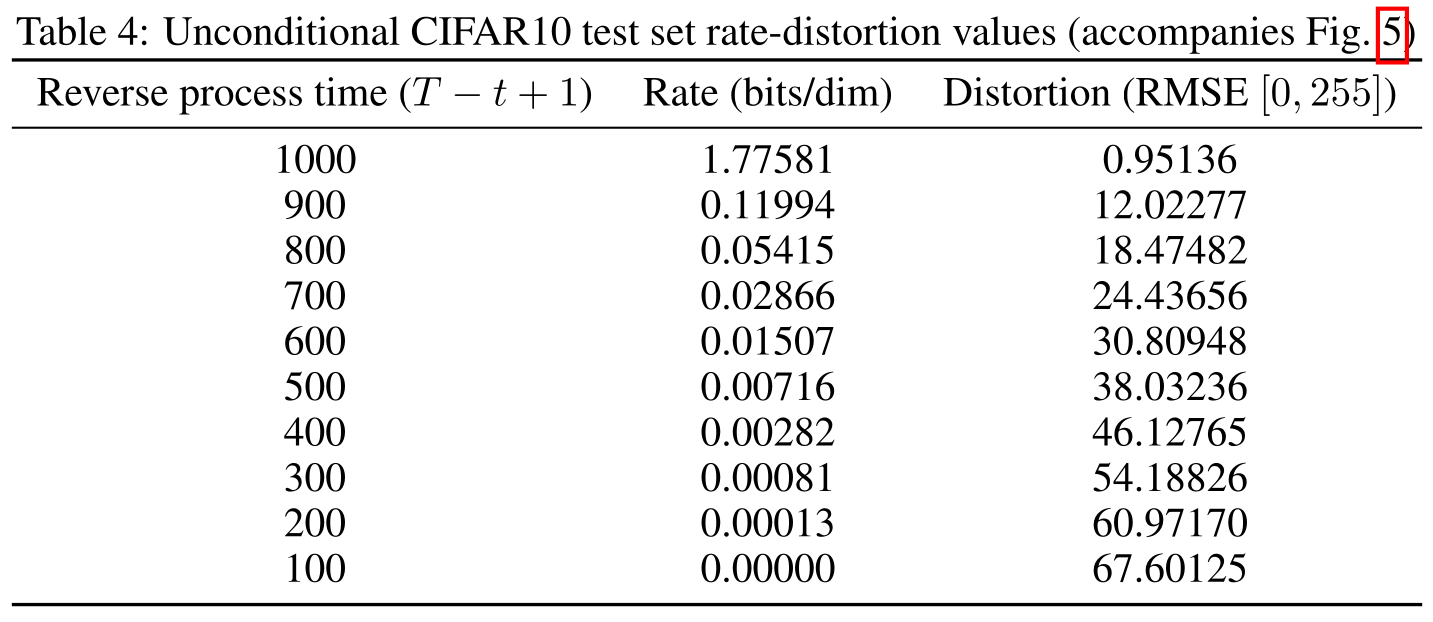
码长(表 1)显示训练–测试差距至多 0.03 比特/维度,与其它似然模型相当,说明未过拟合(附录 D 的近邻可视化亦支持)。不过无损码长仍逊于其它基于似然的模型(但优于 EBM/分数匹配的 AIS 估计)。既然样本质量仍然很高,作者推断存在一种有利于极佳有损压缩的归纳偏置:把 $\mathcal{L}_1 + \dots + \mathcal{L}_T$ 视为码率、$\mathcal{L}_0$ 视为失真,质量最高的 CIFAR-10 模型具有码率 1.78 比特/维度与失真 1.97 比特/维度(在 $0$–$255$ 尺度上 RMSE 0.95),即超过一半的无损码长描述的是不可感知的失真。
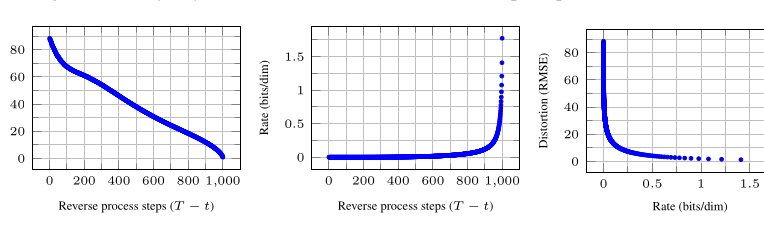
为探究率失真行为,作者引入渐进式有损编码(算法 3–4),假设存在诸如最小随机编码的收发过程,能平均用约 $D_{\mathrm{KL}}(q | p)$ 比特传输 $x \sim q(x)$;按序传输 $x_T,\dots,x_0$ 的期望码长恰为式 5。接收方在任意时刻 $t$ 可重建:
$$ x_0 \approx \hat x_0 = \frac {x_{t}-\sqrt{1-\bar\alpha_t},\epsilon_{\theta}(x_{t})}{\sqrt{\bar\alpha_{t}}}, \tag{DDPM 式 15} $$
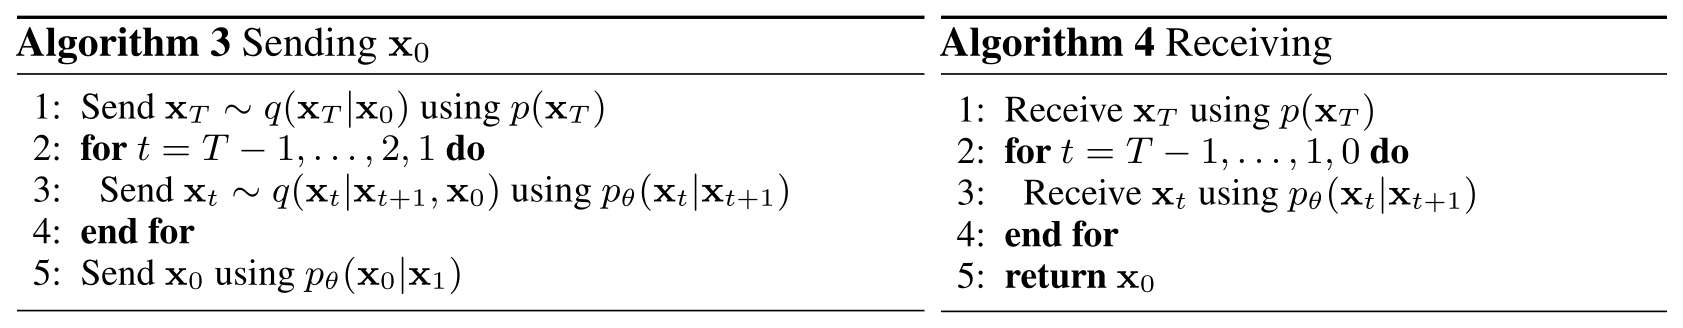
率失真曲线(图 5、表 4)显示失真在低码率区急剧下降,再次表明大部分比特用于不可感知细节。他们还进行了渐进生成:采样过程中预测 $\hat x_0$ 显示粗尺度特征先出现、细节最后出现;冻结 $x_t$ 并抽取 $x_0 \sim p_\theta(x_0 \mid x_t)$ 则显示小 $t$ 保留大部分内容、大 $t$ 只保留粗特征。
与自回归解码的联系。 作者把变分界重写为
$$ \begin{aligned} \mathcal{L} & = D_{\mathrm{KL}}(q(x_T), | , p(x_T))\\ & + \mathbb{E}_q[\sum_{t\ge1} D_{\mathrm{KL}}(q(x_{t-1} \mid x_t), | , p_\theta(x_{t-1} \mid x_t))]\\ & + H(x_0). \end{aligned} \tag{DDPM 式 16} $$
令 $T$ 等于数据维度、令 $q(x_t \mid x_0)$ 把前 $t$ 个坐标掩掉、令先验全部质量落在空白图像上、并假定 $p_\theta$ 完全表达,则 $D_{\mathrm{KL}}(q(x_T)| p(x_T))= 0$,每个 KL 变为坐标复制/预测——即高斯扩散是一种具有广义比特序的自回归模型,且该序无法通过重排数据坐标表达。鉴于此类重排会引入影响样本质量的归纳偏置,作者推测高斯扩散起着类似(可能更强)的作用,并指出 $T$ 无需等于数据维度。
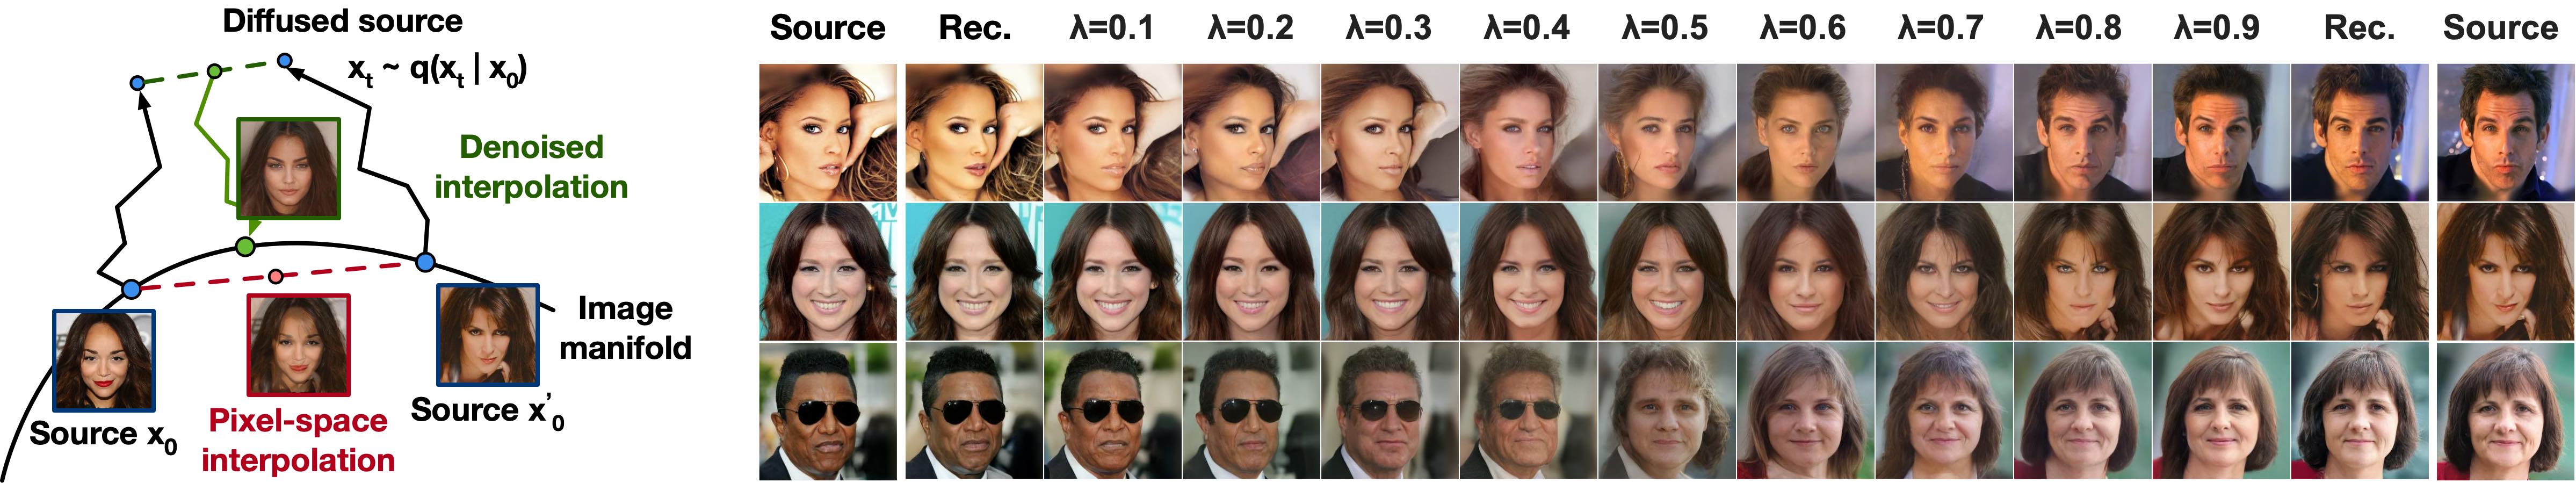
插值
两个噪声的插值去噪后会融合两个源图像的特征。 源图像 $x_0,x_0 ‘$ 经 $q$ 编码为 $x_t,x_t ‘ \sim q(x_t \mid x_0)$;对隐变量做线性插值 $\bar x_t =(1 - \lambda)x_t + \lambda x_t ‘$,再由逆向过程解码 $\bar x_0 \sim p(x_0 \mid \bar x_t)$,实际上是让逆向过程去除插值伪影(不同 $\lambda$ 固定同一噪声)。在 CelebA-HQ $256 \times 256$、$t = 500$ 时(图 8),重建质量高,插值能合理地改变姿态、肤色、发型、表情与背景(但不能改变眼镜);更大 $t$ 得到更粗、更多样的插值,$t = 1000$ 给出全新样本。
相关工作
论文把扩散模型与流和 VAE 对照:扩散模型的前向过程 $q$ 无参数,顶层隐变量 $x_T$ 与 $x_0$ 的互信息近乎为零。$\epsilon$ 预测参数化把扩散与“多噪声水平去噪分数匹配 + 退火 Langevin 采样”联系起来;但与 NCSN 不同,扩散模型支持直接的对数似然计算,并通过变分推断显式训练 Langevin 式采样器。反向含义是:某种加权形式的去噪分数匹配等价于用变分推断拟合 Langevin 式采样器。论文还引用了其它转移算子学习方法(注入训练、变分回走、GSN),指出了经由分数/EBM 联系对基于能量模型的启示,把其率失真评估与退火重要性采样相联系,并把渐进解码与卷积 DRAW 及子尺度顺序自回归模型联系起来。
结论
DDPM 得出结论:扩散模型可实现高质量图像样本,并把训练马尔可夫链的变分推断、去噪分数匹配、退火 Langevin 动力学(以及由之推广的基于能量的模型)、自回归模型、渐进式有损压缩联系起来。鉴于其归纳偏置对图像似乎极为合适,作者期望将其用于其它模态,并作为更大系统中的组件。Broader Impact 部分讨论了恶意用途(伪造图像、数据集偏置放大)与有益用途(压缩、表示学习、创意工具)。
附录小结(DDPM A–D)
- A. 扩展推导: 从 Sohl-Dickstein 等逐步推导式 5,以及 §4.3 所用、不可直接估 计的替代分解式 16。
- B. 实验细节: 基于 Wide ResNet 的 PixelCNN++ 式 U-Net,权重归一化→组归一 化,$32 \times 32$ 用四个分辨率、$256 \times 256$ 用六个,每个分辨率两个残差 块,$16 \times 16$ 处自注意力,正弦 $t$ 嵌入;参数量 35.7M(CIFAR-10)、114M(LSUN/CelebA-HQ)、约 256M(大 LSUN Bedroom);TPU v3-8;CIFAR 批 128 时 21 步/秒(80 万步需 10.6 小时),采样 256 张需 17 秒;$256^2$ 模型批 64 时 2.2 步/秒,采样 128 张需 300 秒;训练步 数:CelebA-HQ 0.5M、LSUN Bedroom 2.4M、Cat 1.8M、Church 1.2M、大 Bedroom 1.15M。超参数:$\beta$ 线性 $10^{-4} \to 0.02$(使 $L_T \approx 0$),CIFAR-10 上 dropout 0.1、其余为 0,水平翻转(LSUN Bedroom 除外),Adam lr $2 \times 10^{-4}$($256^2$ 用 $2 \times 10^{-5}$),批 128/64,EMA 衰减 0.9999;在 5 万张样本上计算指标。
- C. 相关工作讨论: 与 NCSN 的四点具体差异——使用带自注意力的 U-Net 并在所有 层做 $t$ 条件化;前向过程每步把数据缩放 $\sqrt{1-\beta_{t}}$(NCSN 无此缩 放),保持输入尺度一致;前向过程破坏信号 ($D_{\mathrm{KL}}(q(x_T|x_0)| \mathcal{N}(0,I))\approx 0$)且 $\beta_t$ 极 小,避免采样时的分布偏移;采样器系数由 $\beta_t$ 严格导出,因而训练通过变分推 断直接优化采样器质量,而非事后手工调节系数。
- D. 样本: 额外样本;在 $t \in{1000,750,500,250}$ 处拆分逆向链的隐结构实 验表明中间隐变量编码了不可感知的高层属性;随插值前扩散步数增加的由粗到细插值; 近邻;渐进生成。
Score-SDE
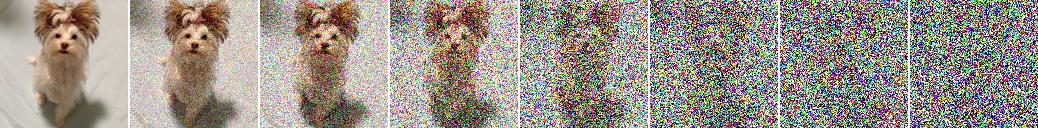
引言把 SMLD 与 DDPM 定位为两类成功的模型:它们用逐渐增强的噪声依次破坏数据,再学习反转这一破坏。SMLD 在每个噪声尺度估计分数,并用噪声递减的 Langevin 动力学采样;DDPM 训练概率模型反转每一步噪声,并在连续状态空间上隐式地为每个尺度计算分数。论文因此把二者统称为基于分数的生成模型,并引用其在图像、音频、图与形状上的应用。
本文的贡献是一个统一的连续时间框架:不再使用有限个噪声分布,而让一个连续统按扩散过程演化,即一个预先规定、无可训练参数的前向 SDE(Stochastic Differential Equations,随机微分方程)。借助 Anderson 的逆向时间 SDE(它只依赖含时分数 $\nabla_x \log p_t(x)$)反转该过程,即可训练含时分数网络并用数值 SDE 求解器生成样本。它声称的贡献包括:(i) 通过通用 SDE 求解器、PC 采样器与给出精确似然的概率流 ODE,实现灵活的采样与似然计算;(ii) 借助单一无条件模型对辅助信息(类别标签、修复、上色等逆问题)进行条件化,实现可控生成;(iii) 一个把 SMLD 与 DDPM 视为两个 SDE 离散化的统一框架。报告的主要结果:CIFAR-10 IS 9.89、FID 2.20、2.99 比特/维度,以及首个基于分数模型的高保真 $1024 \times 1024$ 样本。
背景
配 Langevin 动力学的去噪分数匹配(SMLD)
令 $p_\sigma(\tilde x \mid x): = \mathcal{N}(\tilde x;x,\sigma^2 I)$、$p_\sigma(\tilde x): = \int p_{\text{data}}(x)p_\sigma(\tilde x \mid x), dx$;取噪声尺度 $\sigma_{\min} = \sigma_1 < \cdots < \sigma_N = \sigma_{\max}$,满足 $p_{\sigma_{\min}} \approx p_{\text{data}}$、$p_{\sigma_{\max}} \approx \mathcal{N}(x;0,\sigma_{\max}^2 I)$。NCSN $s_\theta(x,\sigma)$ 以 DSM 目标的加权和训练:
$$ \theta^* = \arg \min_\theta \sum_{i=1}^N \sigma_i^2 , \mathbb{E}_ {p_{\text{data}}(x)} \mathbb{E}_{p_{\sigma_i}(\tilde x\mid x)} [| s_\theta(\tilde x,\sigma_i)- \nabla_{\tilde x} \log p_{\sigma_i}(\tilde x \mid x)|_2^2] . \tag{SDE 式 1} $$
最优 $s_{\theta^*}(x,\sigma)$ 几乎处处匹配 $\nabla_x \log p_\sigma(x)$。采样时对每个 $p_{\sigma_i}$ 依次运行 $M$ 步 Langevin MCMC:
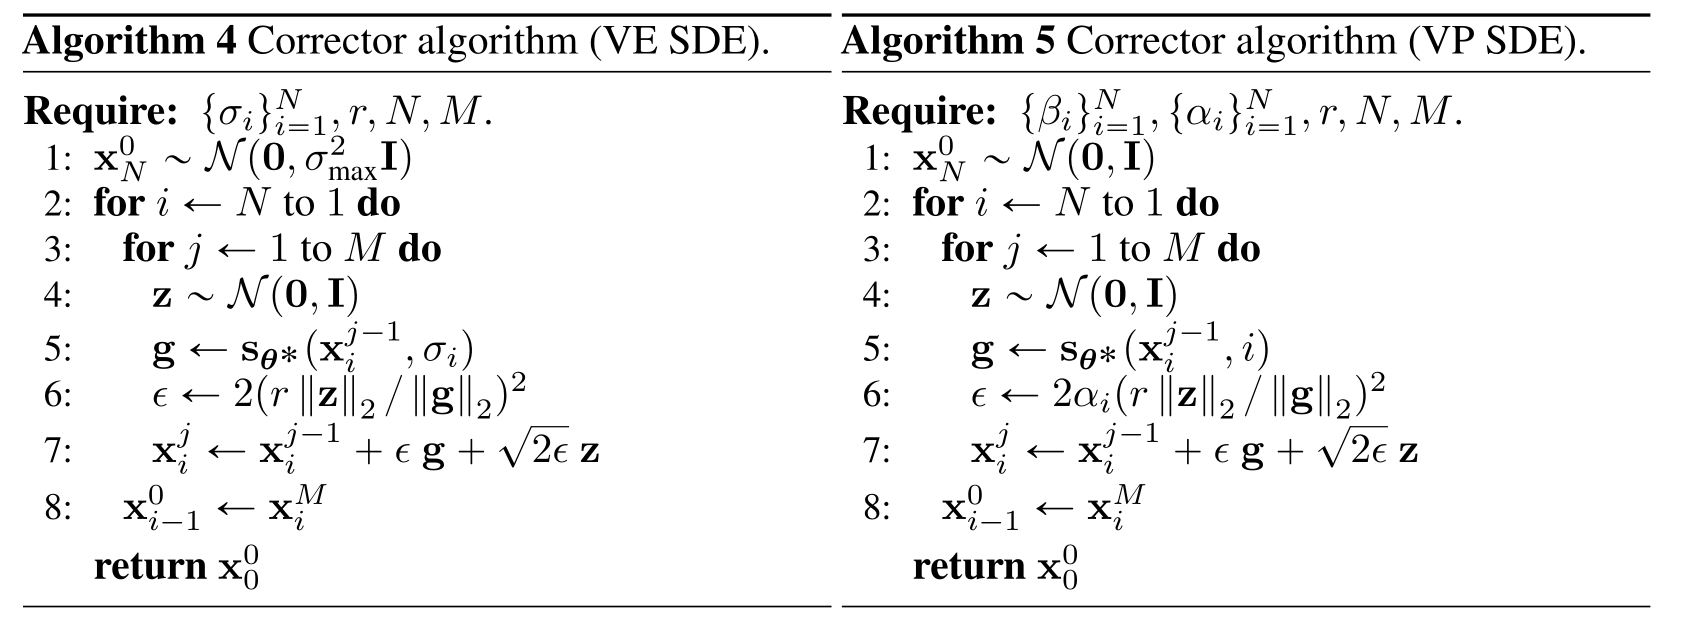
$$ x_i^m = x_i^{m-1} + \epsilon_i , s_{\theta^*}(x_i^{m-1},\sigma_i)+ \sqrt {2\epsilon_{i}} , z_i^m,\qquad m = 1,\dots,M,\tag{SDE 式 2} $$
对 $i = N,\dots,1$ 依次进行,$x_N^0 \sim \mathcal{N}(x \mid 0,\sigma_{\max}^2 I)$,当 $i < N$ 时 $x_i^0 = x_{i+1}^M$;当 $M \to \infty$、$\epsilon_i \to 0$ 时,$x_1^M$ 成为 $p_{\sigma_{\min}} \approx p_{\text{data}}$ 的精确样本。
去噪扩散概率模型(DDPM)
取噪声尺度 $0 < \beta_1 < \cdots < \beta_N < 1$,链为 $p(x_i \mid x_{i-1})= \mathcal{N}(x_i;\sqrt{1-\beta_{i}} x_{i-1},\beta_i I)$,从而 $p_{\alpha_i}(x_i \mid x_0)= \mathcal{N}(x_i;\sqrt{\alpha_{i}} x_0,(1 - \alpha_i)I)$,其中 $\alpha_i : = \prod_{j=1}^i(1 - \beta_j)$,终端 $x_N \approx \mathcal{N}(0,I)$。逆向链为 $p_\theta(x_{i-1} \mid x_i)= \mathcal{N}(x_{i-1};\frac{1}{\sqrt{1-\beta_{i}}}(x_i + \beta_i s_\theta(x_i,i)),\beta_i I)$,以重加权的 ELBO 训练:
$$ \theta^* = \arg \min_\theta \sum_{i=1}^N(1 - \alpha_i), \mathbb{E}_ {p_{\text{data}}(x)} \mathbb{E}_{p_{\alpha_i}(\tilde x\mid x)} [| s_\theta(\tilde x,i)- \nabla_{\tilde x} \log p_{\alpha_i}(\tilde x \mid x)|_2^2] . \tag{SDE 式 3} $$
采样为祖先采样:
$$ x_{i-1} = \frac{1}{\sqrt{1-\beta_{i}}}(x_i + \beta_i s_{\theta^*}(x_i,i))+ \sqrt {\beta_{i}} , z_i,\qquad i = N,\dots,1. \tag{SDE 式 4} $$
式 3 正是 DDPM 的 $\mathcal{L}_{\text{simple}}$,此处重写以显现其与式 1 的相似性:二者都是 DSM 目标的加权和,权重 $\sigma_i^2$ 与 $(1 - \alpha_i)$ 都与扰动核分数期望平方范数成反比。
基于 SDE 的分数生成建模
标准维纳过程和伊藤 SDE
标准维纳过程就是一个从 0 出发、连续但极其抖动的随机游走,它在任意一小段时间里的增量都独立且服从均值为 0、方差等于时间长度的正态分布,因此可以看作连续不断的随机噪声源。
伊藤 SDE 就是用这种噪声驱动的微分方程,写成
$$ dX_t = b(t,X_t)dt + \sigma(t,X_t)dW_t $$
意思是 $X_t$ 的微小变化等于一个确定的趋势项加上一个由维纳增量 $dW_t$ 带来的随机抖动,而其中的随机积分按伊藤规则理解:只利用当前已知信息、不偷看未来,所以积分结果不是一条确定路径而是一个随机变量,并且计算时必须用伊藤引理,因而会多出普通微积分没有的二阶修正项:
$$ df(t,X_t)=(f_t + b f_x + \frac{1}{2} \sigma^2 f_{xx})dt + \sigma f_x , dW_t $$
提示: 这一步通过泰勒展开得到,展开的所有项中,一次项必须保留,二次项中 $(dX_t)^2$ 由于随机项的平方 $(\sigma dW_T)^2 \approx \sigma^2d_t$ 无法被忽略,也必须保留,其余都可视为 0,比如 $dt^2$, $dt^3$ 和 $(dX_t)^3$ 等。
用 SDE 扰动数据
有限噪声尺度集合被推广为连续统 $t \in[0,T]$,其中 $x(0)\sim p_0$(数据)、$x(T)\sim p_T$(可处理的先验),$x(t)\sim p_t(x)$ 由伊藤 SDE 支配:
$$ dx = f(x,t), dt + g(t), dw,\tag{SDE 式 5} $$
其中 $w$ 为标准维纳过程,$f(\cdot,t): \mathbb{R}^d \to \mathbb{R}^d$ 为漂移系数,$g(\cdot): \mathbb{R} \to \mathbb{R}$ 为(标量、与状态无关的)扩散系数。只要系数对状态 $x$ 与时间 $t$ 全局 Lipschitz 连续(也就是 $x$ 或 $t$ 的微小改动不能引起系数的剧烈变动),解唯一且强存在;$p_t(x)$ 记 $t$ 时刻密度,$p_{st}(x(t)\mid x(s))$ 记转移核。通常 $p_T$ 是不含 $p_0$ 信息的无结构高斯先验(正态)。
通过反转 SDE 生成样本
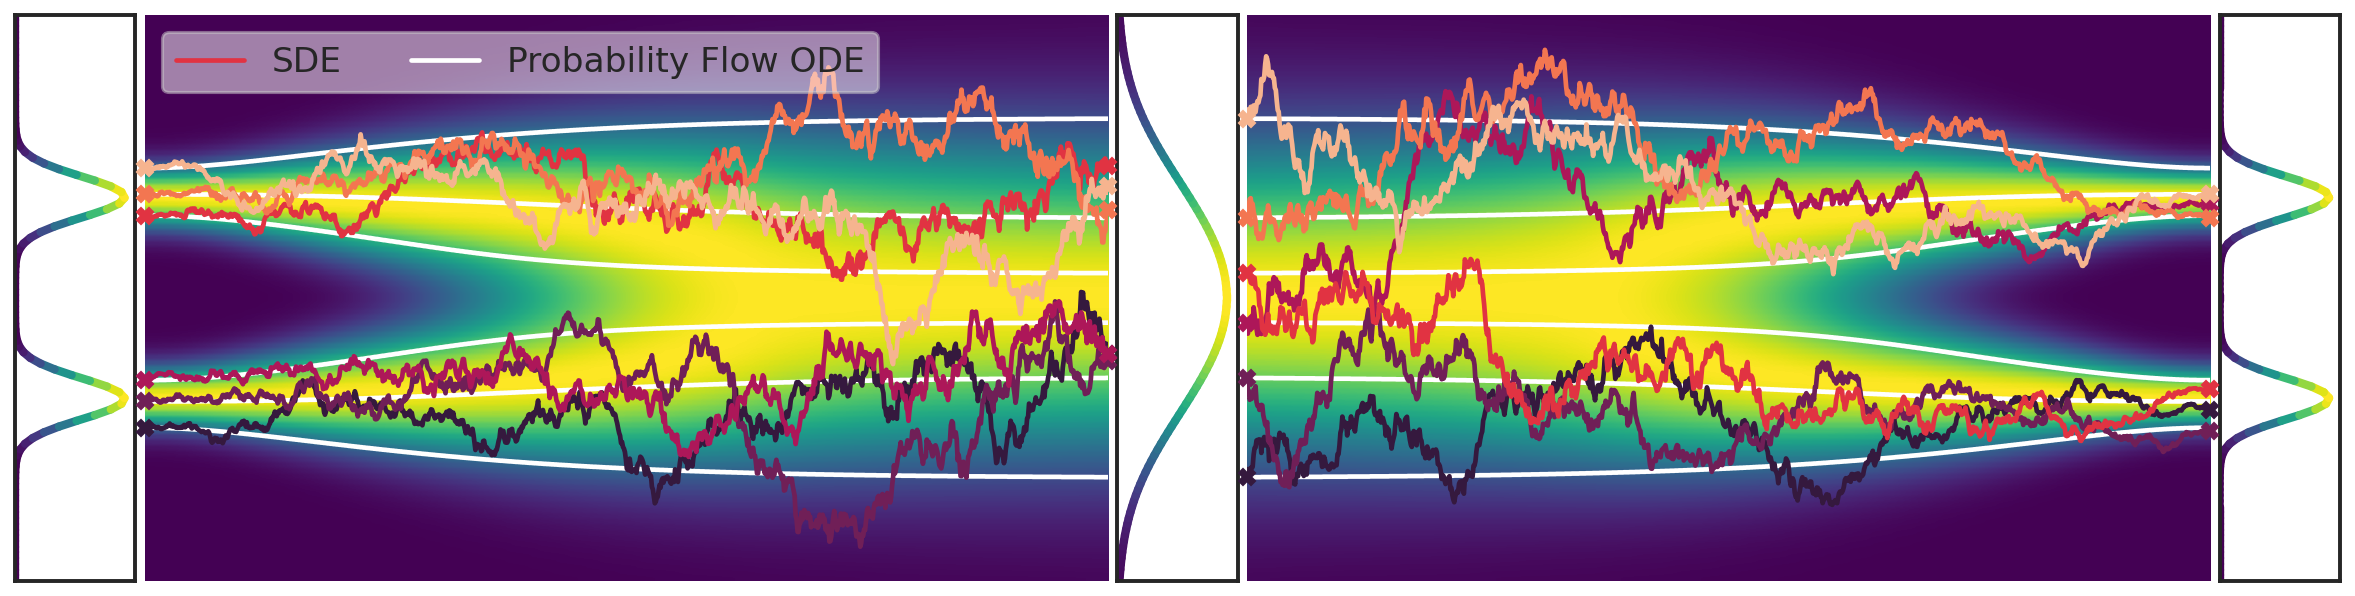
Anderson 定理(Anderson 的时间反转定理,Anderson’s Time Reversal Theorem)指出,扩散过程的反向仍是扩散过程,其时间倒流,由逆向时间 SDE 给出:
$$ dx =[f(x,t)- g(t)^2 \nabla_x \log p_t(x)]dt + g(t), d \bar w,\tag{SDE 式 6} $$
其中 $\bar w$ 是时间从 $T$ 流向 $0$ 的标准维纳过程,$dt$ 为无穷小负时间步。一旦对所有 $t$ 已知分数 $\nabla_x \log p_t(x)$,便可用式 6 采样。采样的方式是,从一个标准正态分布出发,利用上式积分逐步得到最终样本。式 6 的完整推导如下。
逆向时间 SDE 的推导
正向 SDE 和其密度满足 Fokker–Planck:
$$ dX_t = f(X_t,t)dt + g(t)dW_t, $$
$$ \partial_t p_t(x)= - \nabla_x \cdot(f(x,t)p_t(x))+ \frac{1}{2} g(t)^2 \Delta_x p _t(x)= - \nabla_x \cdot[(f(x,t)- \frac{1}{2} g(t)^2 \nabla_x \log p_t(x))p_t(x)] . $$
令反向时间 $\tau = T - t$,反向状态 $Y_\tau = X_{T-\tau}$,其密度 $q_\tau(y)= p_{T-\tau}(y)$。于是
$$ dY_\tau = b_{\rm rev}(Y_\tau,\tau)d \tau + g(T - \tau)d \bar W_\tau . $$
$$ \partial_\tau q_\tau(y)= - \partial_t p_t(y)\big |_{t=T-\tau} = - \nabla_y \cdot [(- f(y,T - \tau)+ \frac{1}{2} g(T - \tau)^2 \nabla_y \log q_\tau(y))q_\tau(y)]. $$
两项漂移必须相等,所以
$$ b_{\rm rev}(y,\tau)- \frac{1}{2} g(T - \tau)^2 \nabla_y \log q_\tau(y)= - f(y,T - \tau)+ \frac{1}{2} g(T - \tau)^2 \nabla_y \log q_\tau(y), $$
$$ b_{\rm rev}(y,\tau)= - f(y,T - \tau)+ g(T - \tau)^2 \nabla_y \log q_\tau(y), $$
又由于 $d \tau = - dt$,所以
$$ dX_t =[f(X_t,t)- g(t)^2 \nabla_x \log p_t(X_t)]dt + g(t)d \bar W . $$
为 SDE 估计分数
含时分数模型 $s_\theta(x,t)$ 通过式 1 与式 3 的连续推广来训练:
$$ \theta^* = \arg \min_\theta \mathbb{E}_t{\lambda(t), \mathbb{E}_{x(0)} \mathbb {E}_{x(t)\mid x(0)} [| s_\theta(x(t),t)- \nabla_{x(t)} \log p_{0t}(x(t)\mid x(0))|_2^2]},\tag {SDE 式 7} $$
其中 $\lambda :[0,T]\to \mathbb{R}_{>0}$ 为正权重,$t \sim \mathcal{U}[0,T]$。在足够数据与容量下 $s_{\theta^*}(x,t)= \nabla_x \log p_t(x)$ 几乎处处成立;常用选择为 $\lambda \propto 1 / \mathbb{E}[| \nabla \log p_{0t} |_2^2]$。关于权重的选择为什么要与分数的范数平方成反比可以参考此处。这是去噪分数匹配,但切片与有限差分分数匹配同样适用。
若 $f$ 为仿射,则转移核为高斯且有闭式均值/方差,条件分数可直接计算,因而可直接用去噪分数匹配训练;否则可用 Kolmogorov 前向方程,或直接模拟 SDE 采样 $p_{0t}$ 并改用切片分数匹配。
示例:VE、VP SDE 及更多
SMLD 的马尔可夫链 $x_i = x_{i-1} + \sqrt{\sigma_{i}^{2}-\sigma_{i-1}^{2}} , z_{i-1}$(引入 $\sigma_0 = 0$)在 $N \to \infty$、$\sigma \to \sigma(t)$ 时变为方差爆炸型(VE)SDE:
$$ dx = \sqrt{\frac{d[\sigma^{2}(t)]}{dt}} , dw . \tag{SDE 式 9} $$
DDPM 的链 $x_i = \sqrt{1-\beta_{i}} , x_{i-1} + \sqrt{\beta_{i}} , z_{i-1}$ 变为方差保持型(VP)SDE:
$$ dx = - \frac{1}{2} \beta(t)x , dt + \sqrt{\beta(t)} , dw . \tag{SDE 式 11} $$
差别在于方差行为:VE 过程当 $t \to \infty$ 时方差爆炸,而 VP 过程方差有界(初值为单位方差时恒为 1)附录 B 经由 $\frac{d\Sigma_{\text{VP}}(t)}{dt} = \beta(t)(I - \Sigma_{\text{VP}}(t))$ 得 $\Sigma_{\text{VP}}(t)= I + e^{-\int_0^t\beta(s)ds}(\Sigma_{\text{VP}}(0)- I)$。受 VP 启发,作者提出 sub-VP SDE:
$$ dx = - \frac{1}{2} \beta(t)x , dt + \sqrt {\beta(t)\left(1-e^{-2\int_0^t\beta(s)ds}\right)} , dw,\tag{SDE 式 12} $$
其方差在任意时刻都上界于对应的 VP SDE(故称 sub-VP),在通常条件下仍收敛到标准高斯。三者漂移均为仿射($f(x,t)= A(t)x + b(t)$),故扰动核为高斯且有闭式(附录 B 式 29):
$$ p_{0t}(x(t)\mid x(0))= \begin{cases} \mathcal{N}(x(t);x(0),[\sigma^2(t)- \sigma^2(0)]I)& \text{(VE)} \\ \mathcal{N}(x(t);x(0)e^{-\frac{1}{2}\int_0^t\beta(s)ds},(1 - e^{-\int_0^t\beta(s)ds})I)& \text{(VP)} \\ \mathcal{N}(x(t);x(0)e^{-\frac{1}{2}\int_0^t\beta(s)ds},(1 - e^{-\int_0^t\beta(s)ds})^2 I)& \text{(sub-VP)} \end{cases} $$
这让式 7 的训练高效可行。(具体实例见附录 B/C:VE 用几何 $\sigma(t)$;VP 用线性 $\beta(t)$,$\bar \beta_{\min} = 0.1$、$\bar \beta_{\max} = 20$ 与 DDPM 对齐;因 $\sigma(t)$ 在 $0$ 处不连续、VP 在 $0$ 处方差消失,数值计算限制在 $t \in[\varepsilon,1]$。)
VE, VP, Sub-VP 的对比
| 属性 | VE(SMLD / NCSN) | VP(DDPM) | Sub-VP |
|---|---|---|---|
| 漂移 $f(x,t)$ | $0$ | $-\frac{1}{2} \beta(t)x$ | $-\frac{1}{2} \beta(t)x$ |
| 扩散 $g(t)$ | $\sqrt{\frac{d[\sigma^{2}(t)]}{dt}}$ | $\sqrt{\beta(t)}$ | $\sqrt{\beta(t)(1-\alpha_{t}^{2})}$ |
| 边缘分布 $q(x_t \mid x_0)$ | $\mathcal{N}(x_0,\sigma^2(t)I)$ | $\mathcal{N}(\sqrt{\alpha_{t}} x_0,(1 - \alpha_t)I)$ | $\mathcal{N}(\sqrt{\alpha_{t}} x_0,(1 - \alpha_t)^2I)$ |
| 先验 $p_T$ | $\mathcal{N}(0,\sigma_{\max}^2 I)$ | $\mathcal{N}(0,I)$ | $\mathcal{N}(0,I)$ |
其中 Sub-VP 的扩散项里 $\int_0^t \beta$ 即 $\int_0^t \beta(s), ds$,且 $\alpha_t = e^{-\int_0^t\beta(s),ds}$。
求解逆向 SDE
通用数值 SDE 求解器
任意 SDE 求解器(Euler–Maruyama、随机 Runge–Kutta 等)都可积分逆向 SDE。然而这类求解器的工作原理通常也是用离散化近似。
论文指出,祖先采样是逆向 VP SDE 的一种特殊离散化,但为新 SDE 推导祖先规则并非易事。因此提出逆向扩散采样器:以与前向离散化相同的函数形式离散逆向 SDE。给定前向步 $x_{i+1} = x_i + f_i(x_i)+ G_i z_i$,逆向步为
$$ x_i = x_{i+1} - f_{i+1}(x_{i+1})+ G_{i+1} G_{i+1}^\top s_{\theta^*}(x_{i+1},i + 1)+ G_{i+1} z_{i+1} . \tag{SDE 式 46} $$
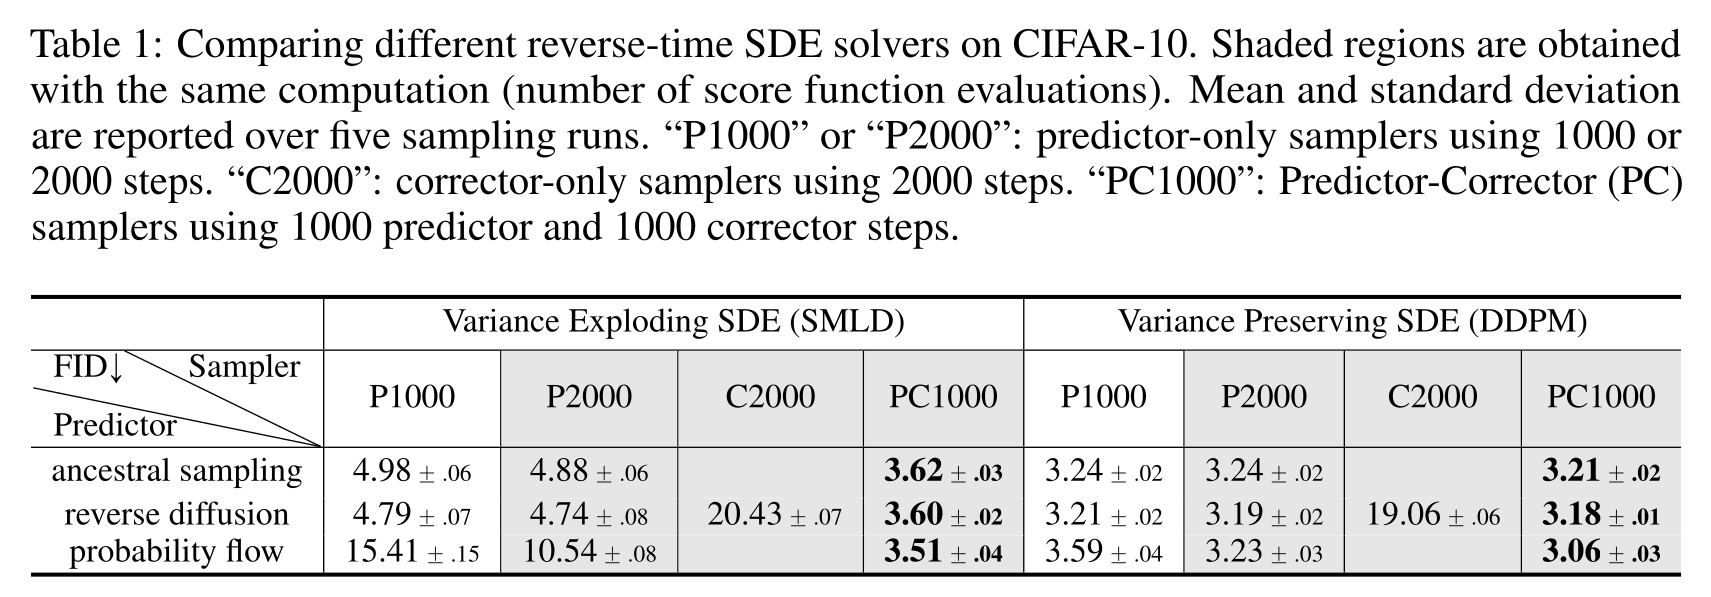
这个公式是套用之前的逆向时间 SDE 公式,也就是 SDE 式 6 得到的。 在 CIFAR-10(表 1)上,原论文通过实验证明了,逆向扩散采样对 SMLD/VE 与 DDPM/VP 模型都略优于祖先采样。
预测器-校正器采样器
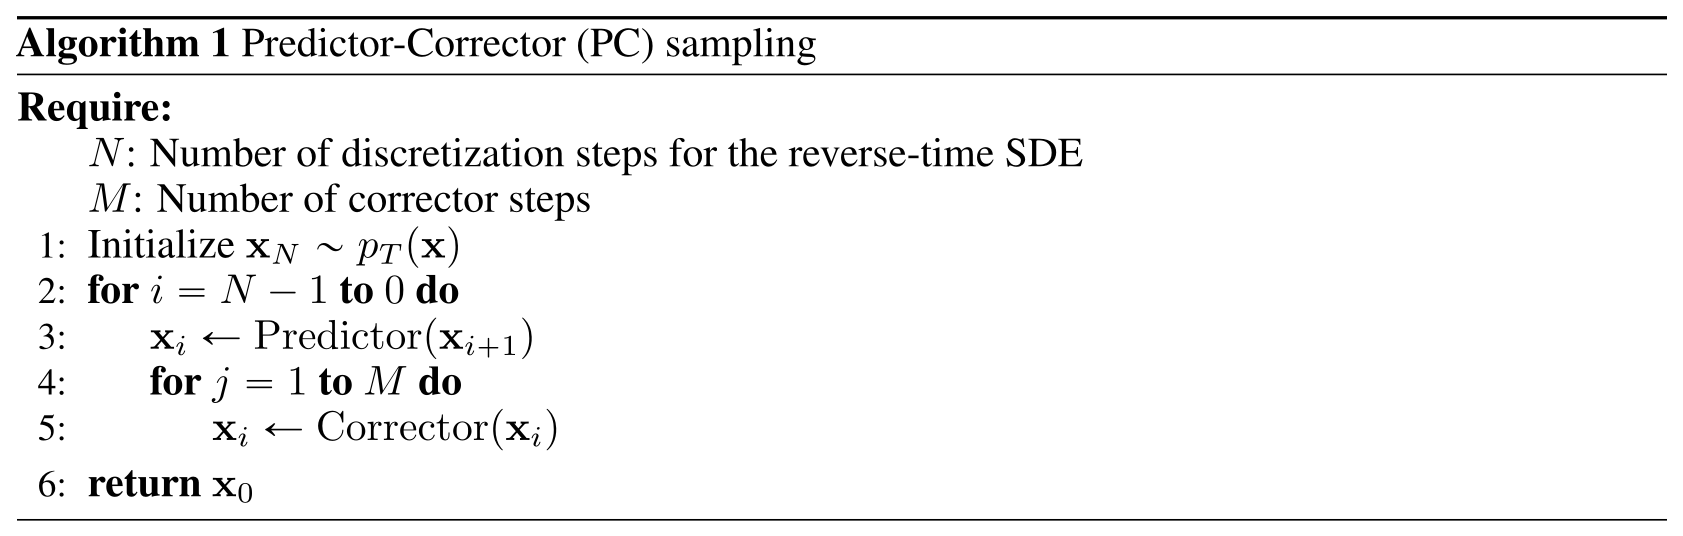
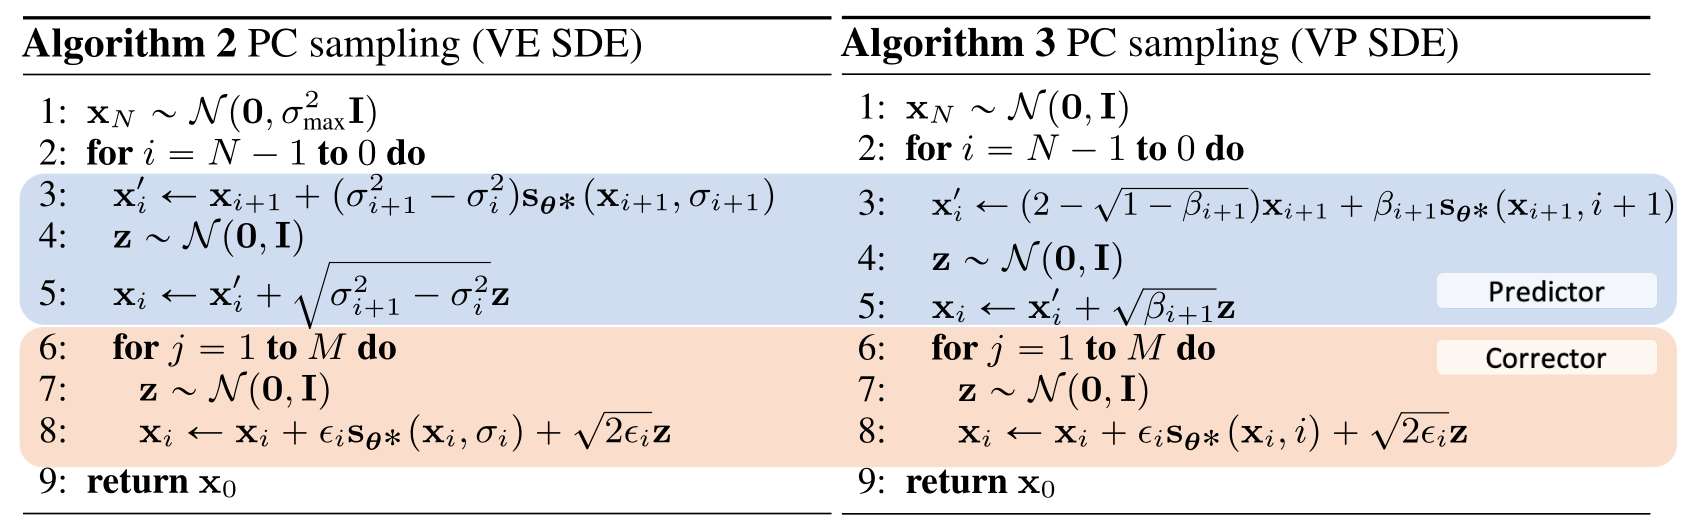
一句话:PC 采样器是一种“边走时间、边修分布”的采样框架。预测器负责把样本从高噪声时刻推向低噪声时刻;校正器负责在当前噪声时刻原地做 MCMC,把样本分布拉回该时刻的真实边缘分布 $p_t$。
PC 采样器交替做两件事:
- 预测器:数值 SDE 求解器估计下一时刻样本,时间前进,从高噪声推向低噪 声。
- 校正器:利用 score 模型 $s_\theta \approx \nabla \log p_t$,用基于分数的 MCMC(如 Langevin、HMC)在固定时刻修分布,使样本更接近真实 $p_t$。
它推广了 SMLD 和 DDPM:
- SMLD = 恒等预测器 + 退火 Langevin 校正器(不预测,只校正)
- DDPM = 祖先预测器 + 恒等校正器(不校正,只预测)
实验结论:相同计算量下 C2000 最差;PC1000 计算翻倍,但总优于 P1000,通常也优于 P2000;适当校正步下 PC 明显优于纯预测器。这里的 1000 和 2000 指采样步数。
概率流及其与神经常微分方程的联系
每个扩散过程都有一个确定性版本(移除了噪声项):概率流 ODE,它与反向 SDE 共享同一组边缘分布 ${p_t}$:
$$ dx =[f(x,t)- \frac{1}{2} g(t)^2 \nabla_x \log p_t(x)]dt . $$
用 $s_\theta \approx \nabla \log p_t$ 替换后,它就是一个神经常微分方程 ODE,因而可以使用 ODE 求解器解出。由于含时分数网络不可直接积,求解器仍然使用离散化的方式求解,所以 PC 采样器在此处仍然能够发挥作用。
ODE 可以计算 精确似然,ODE 的确定性允许用瞬时变量替换公式:
$$ \log p_0(x(0))= \log p_T(x(T))+ \int_0^T \nabla \cdot \tilde f_\theta(x(t),t), dt, $$
其中,散度用 Skilling–Hutchinson 无偏估计,额外代价约一次函数评估。CIFAR-10 上,同一模型的精确似然优于 DDPM ELBO;sub-VP 优于 VP;DDPM++ cont. (deep, sub-VP) 达 2.99 bits/dim。
ODE 带来的 额外收益:1. 可做隐变量操控,如插值、温度缩放等,因为其路径是确定的;2. 用黑盒 ODE 求解器(如 RK45)可减少函数评估 90% 以上而不损视觉质量;3. 前向 SDE/ODE 无可训练参数,不同架构的隐编码逐维一致($r = 0.96$)。
ODE 不用校正器时,其样本的 FID 质量通常不如 SDE 样本,这一点在高维 VE 在下尤其明显,且 ODE 的效果依赖于所选的 SDE。
架构改进
作者在 CIFAR-10 上做网络架构搜索,VE 还额外在 CelebA $64^2$ 上试。基础是 DDPM 的 U-Net,然后加了一堆改进:
FIR 抗锯齿上/下采样:缩放图像时更平滑,减少棋盘格伪影。跳跃连接缩放 $1 / \sqrt{2}$:让训练更稳。BigGAN 残差块:更强的残差结构。每分辨率 4 个残差块:原来 2 个,现在更深。渐进式增长:输入/输出变体,逐步增加分辨率。均衡学习率:试过,但早期有害,弃用。EMA 率:模型参数的滑动平均,VE 用 0.999,VP 用 0.9999。
最佳 VE 模型叫 NCSN++,用了 FIR、跳跃缩放、BigGAN 块、每分辨率 4 块、残差式输入增长,FID 2.45。最佳 VP 模型叫 DDPM++,省略 FIR 和渐进增长,FID 2.78。
改用连续目标式 7 训练,时间嵌入用随机傅里叶特征(也就是用一堆正弦/余弦值凑成的向量表示一个标量时间步 $t$ 的特征),尺度 16,跑 0.95M 次迭代:
NCSN++ cont.:FID 2.38。NCSN++ cont. (deep):加深网络,FID 2.20,IS 9.89,创下无条件 CIFAR-10 新纪录,不用标签就超过之前的类条件模型。DDPM++ cont.:FID 2.55(VP)/ 2.61(sub-VP);加深后都是 2.41,其中 sub-VP 深模型达到 2.99 比特/维度。
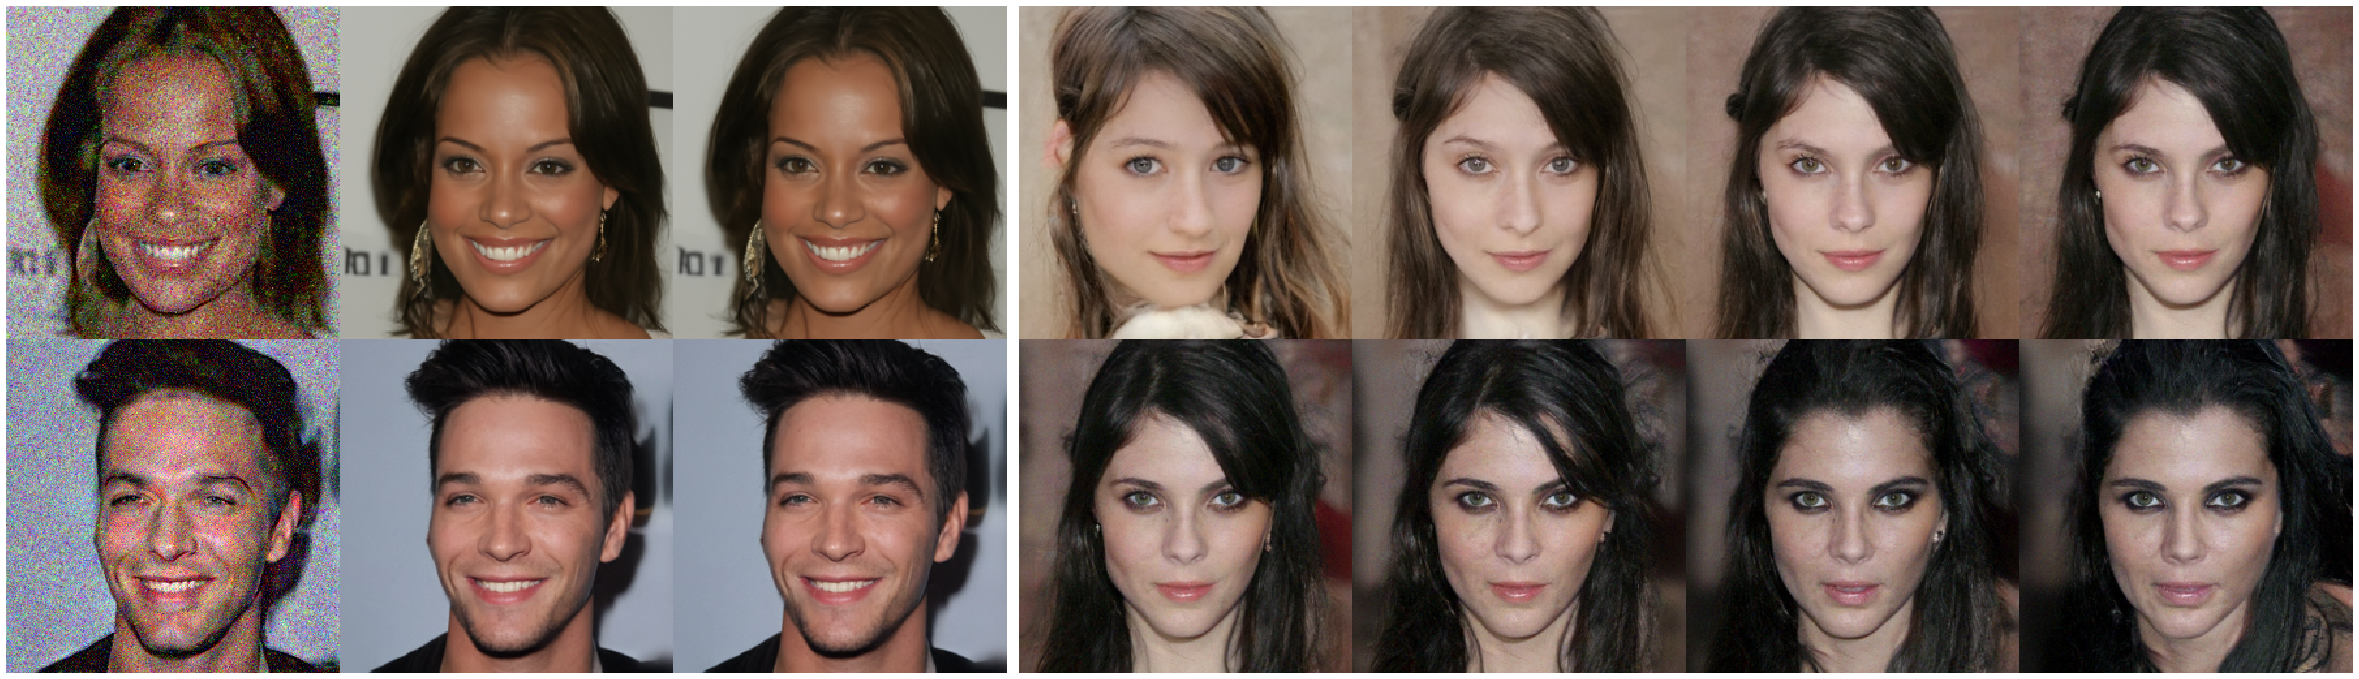
高分辨率方面:改进的 NCSN++ 在 $1024 \times 1024$ CelebA-HQ 上训练,批大小 8,EMA 0.9999,约 2.4M 次迭代,PC 2000 步,信噪比 0.15。这是首个基于分数模型的高保真 $1024^2$ 样本,虽有可见瑕疵,但展示了可扩展性。
可控生成
给定前向 SDE 与已知似然 $p_t(y \mid x(t))$,可通过求解条件逆向时间 SDE 从 $p_0(x(0)\mid y)$ 采样:
$$ dx ={f(x,t)- g(t)^2[\nabla_x \log p_t(x)+ \nabla_x \log p_t(y \mid x)]}dt + g( t), d \bar w,\tag{SDE 式 14} $$
它源自一般恒等式
$$ \nabla_x \log p_t(x(t)\mid y)= \nabla_x \log p_t(x(t))+ \nabla_x \log p(y \mid x (t)). \tag{SDE 式 49} $$
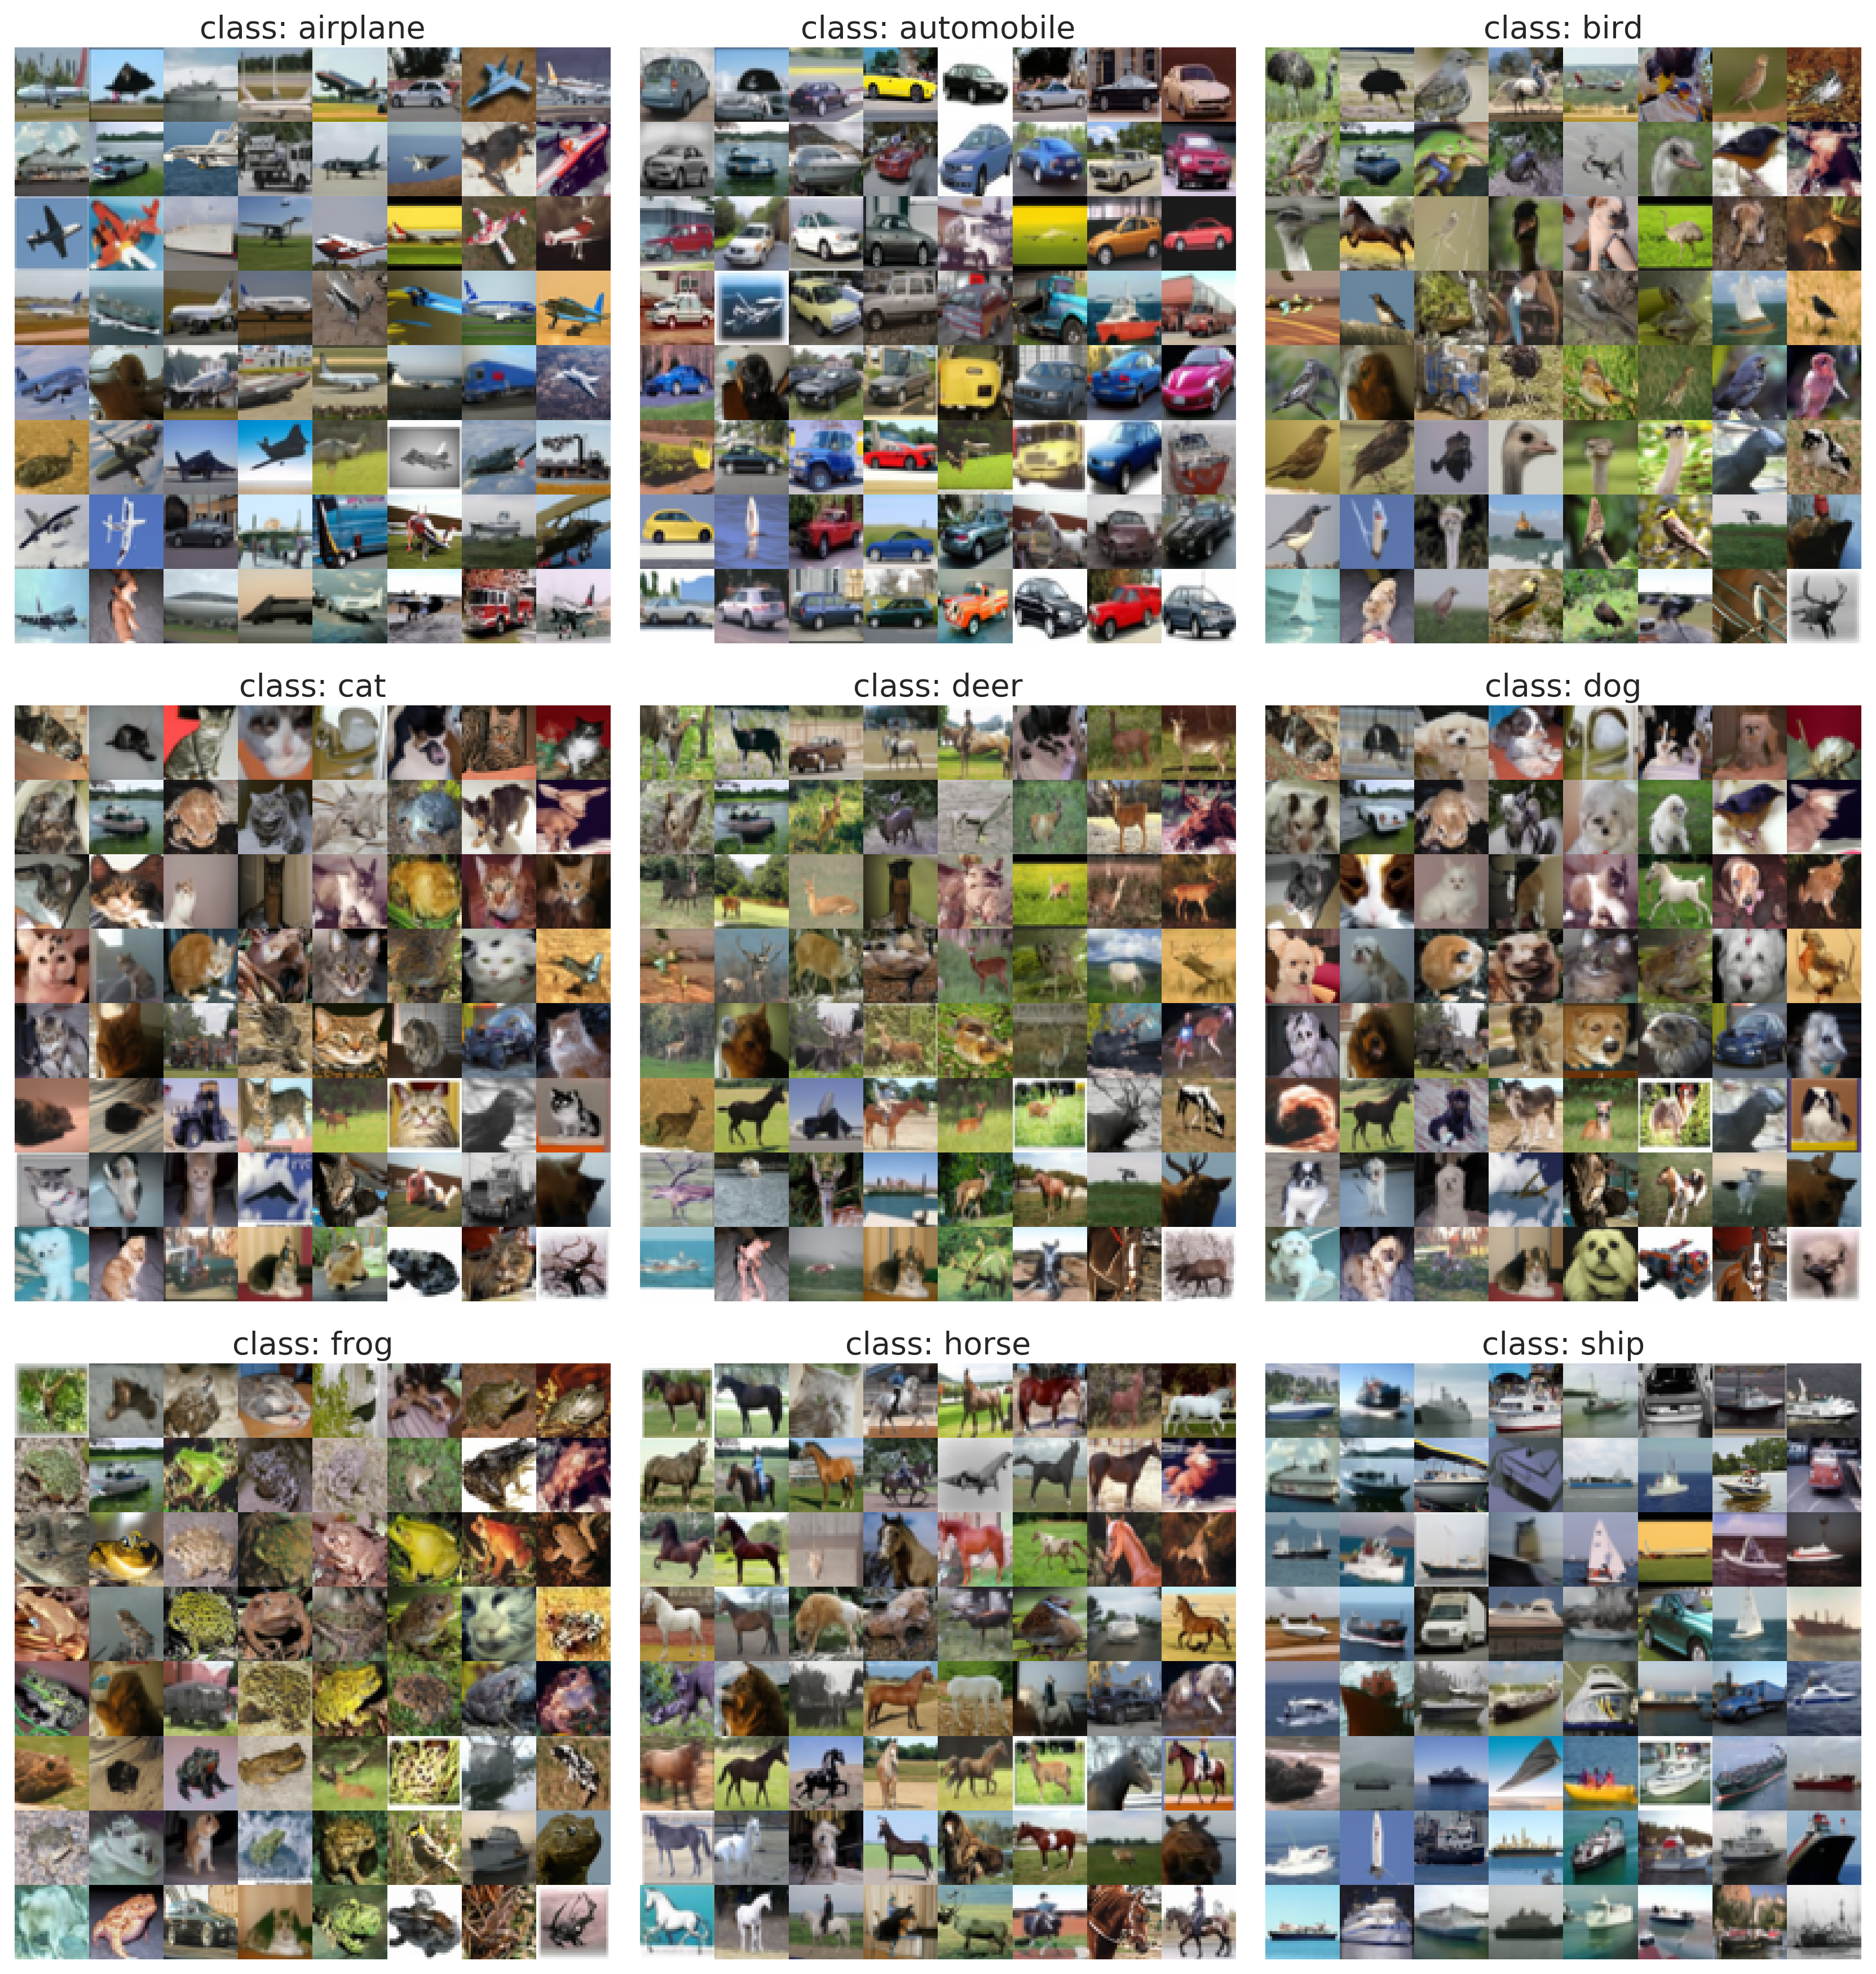
类条件生成: 当 $y$ 为标签时,训练含时分类器 $p_t(y \mid x(t))$,其训练对 $(x(t),y)$ 由先从数据采样 $(x(0),y)$、再采样 $x(t)\sim p_{0t}(x(t)\mid x(0))$ 得到,并对不同时间步的交叉熵损失求和。作者用 Wide-ResNet-28-10 分类器、以随机傅里叶特征对 $\log \sigma_i$ 条件化,并在无条件 NCSN++ 上用 PC(2000 步)生成。
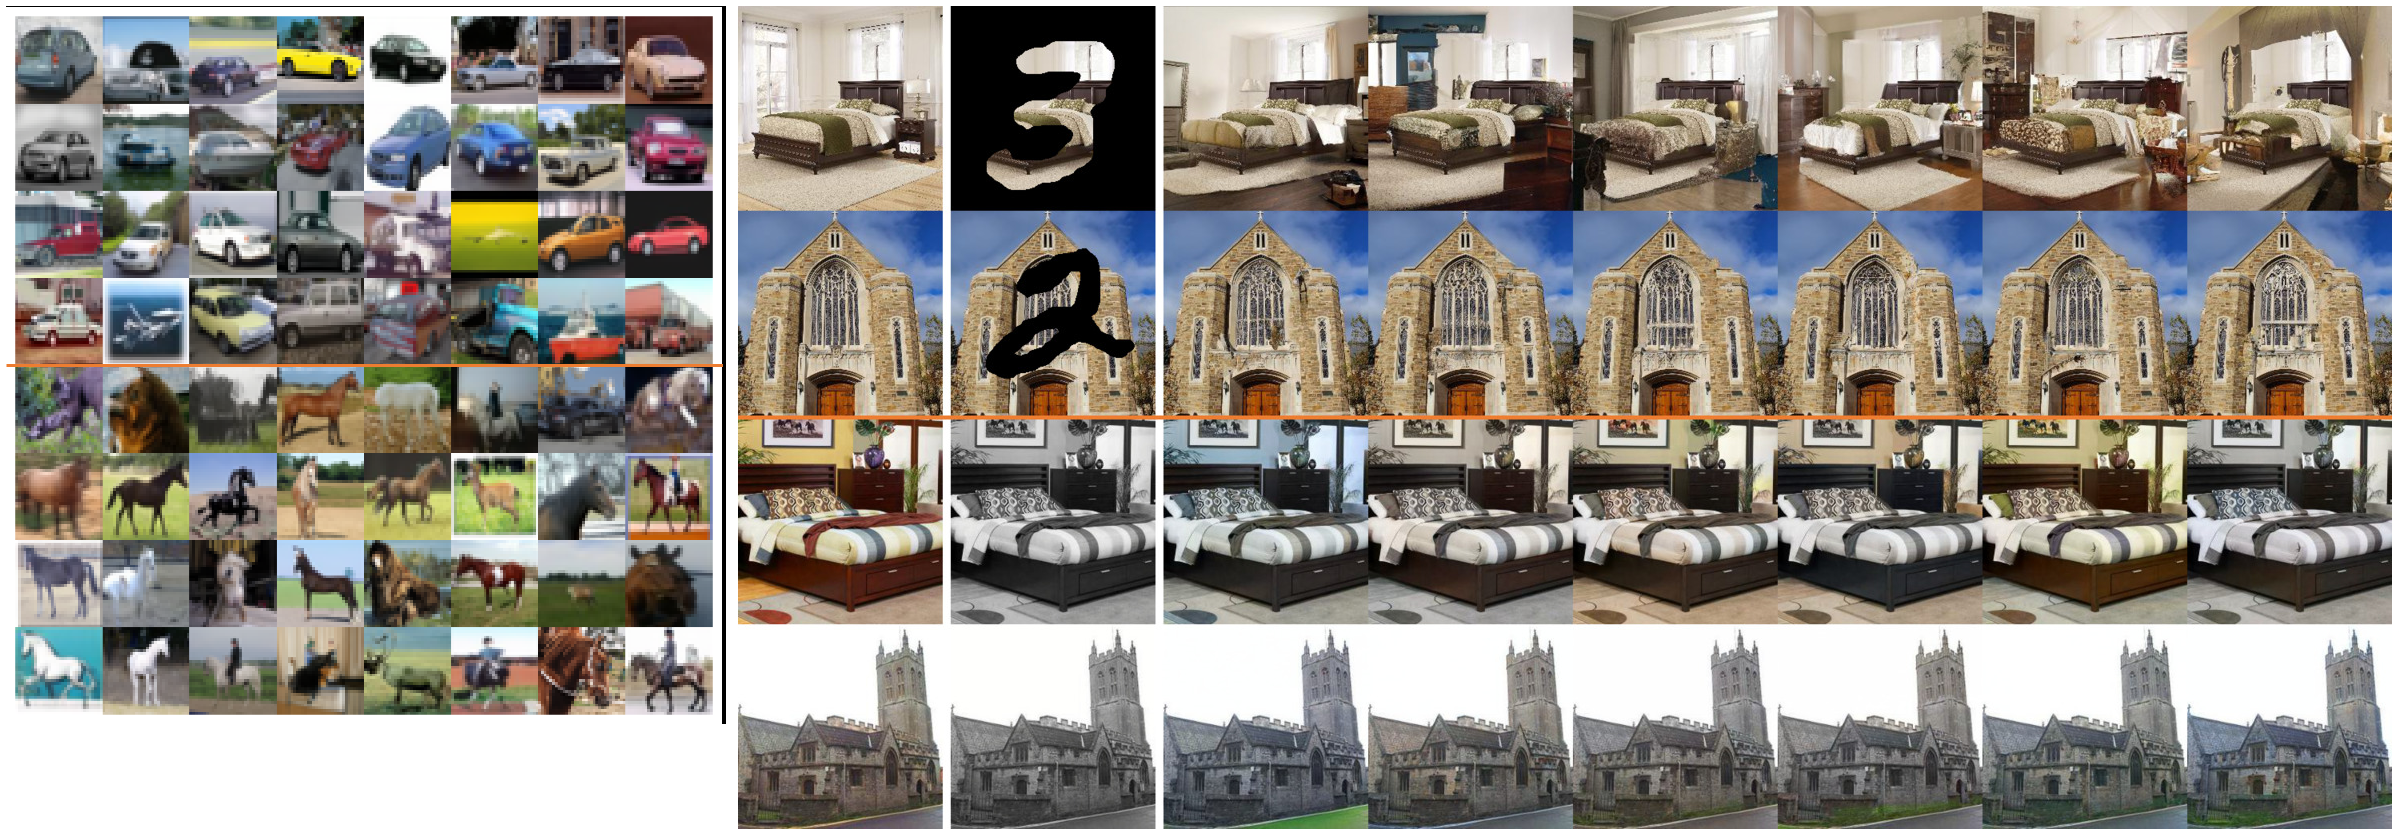
修复(imputation) 是条件采样的特例:设未知维度为 $\bar \Omega(x)$,把 SDE 限制到这些维度,并把不可处理的 $\nabla_z \log p_t(z(t)\mid \Omega(x(0))= y)$ 用从 $p_t(\Omega(x(t))\mid A)$ 采样的 $\hat \Omega(x(t))$ 替换已知部分来近似:
$$ \nabla_z \log p_t(z(t)\mid \Omega(x(0))= y)\approx \nabla_z \log p_t(z(t)\mid \hat \Omega(x(t))). $$
上色(colorization) 是已知维度相互耦合的修复;用一个正交线性变换(论文给出显式矩阵)把彩色通道解耦为灰度通道加独立通道,使标准维纳过程在变换空间中仍为标准维纳过程。
一般逆问题(附录 I.4)假定 $p(y \mid x)$ 已知,并使用
$$ \nabla_x \log p_t(x(t)\mid y)\approx s_{\theta^*}(x(t),t)+ \nabla_x \log p_t( \hat y(t)\mid x(t)),\tag{SDE 式 50} $$
其中 $\hat y(t)\sim p(y(t)\mid y)$,$y(t)$ 通过前向过程定义;其成立依赖两个假设:$p(y(t)\mid y)$ 可处理,且 $p_t(x(t)\mid y(t),y)\approx p_t(x(t)\mid y(t))$(小 $t$ 时 $y(t)\approx y$;大 $t$ 时近似误差在采样早期使用、影响较小)。把式 50 代入式 48 即可求解 $p(x \mid y)$。
结论
关于 SDE 的总结:该框架加深了对已有基于分数方法的理解,并带来新的采样算法、精确似然计算、唯一可辨识编码、隐变量操控与条件生成能力。论文的局限:采样仍慢于 GAN;可用的采样器众多也引入许多超参数;自动选择与调优采样器、以及更深入地研究各采样器的优劣,被列作未来方向。
附录小结(Score-SDE A–I)
- A–C. 一般 SDE 框架与 VE/VP/sub-VP 实例: 附录 A 把扩散系数推广为矩阵值 $G(x,t)$,给出逆向时间 SDE(式 16)、概率流 ODE(式 17)与条件逆向 SDE(式 18),并在非仿射情形下建议改用切片分数匹配(式 19)。附录 B 证明 SMLD 的链(式 20)在 $N \to \infty$ 时收敛到 VE SDE(式 21)、DDPM 的链(式 22)收敛到 VP SDE(式 25),并给出 VP 方差 $\Sigma_{\text{VP}}(t)= I + e^{-\int_0^t\beta(s)ds}(\Sigma_{\text{VP}}(0)- I)$(式 26);新提出的 sub-VP SDE(式 27)方差满足 $\Sigma_{\text{sub-VP}} \le \Sigma_{\text{VP}}$ 且二者都趋于 $I$。附录 C 给出 实例:VE 用几何 $\sigma(t)$(式 30–31,取 $\varepsilon = 10^{-5}$),VP 用线性 $\beta(t)$(式 32–33,$\bar \beta_{\min} = 0.1$、$\bar \beta_{\max} = 20$,采 样 $\varepsilon = 10^{-3}$、训练/似然 $10^{-5}$),sub-VP 沿用相同 $\beta(t)$(式 34);图 5 显示离散核与 SDE 核($N = 1000$)几乎完全吻合。
- D–F. 概率流 ODE 与逆向/祖先采样: 附录 D 由 Fokker–Planck 方程(式 35–37) 推导概率流 ODE,并用瞬时变量替换(式 38–39)与 Skilling–Hutchinson 估计器(式 40)计算精确似然(RK45,atol=rtol=$10^{-5}$);给出确定性采样迭代(式 42–44),指出黑盒 ODE 求解器不加校正器时 FID 通常不如 SDE 采样,并用两种架构 (Model A/B,每分辨率 4/8 层)验证唯一可辨识编码($r \approx 0.96$)。附录 E 以同一函数形式离散逆向 SDE 得到逆向扩散采样器(式 45–46,即预测器),并说明 DDPM 祖先采样是其在 $\beta_i \to 0$ 下的特例。附录 F 为 SMLD 导出相应的祖先采 样迭代(式 47,$\mu_\theta(x_i,i)= x_i +(\sigma_i^2 - \sigma_{i-1}^2)s_\theta(x_i,i)$)。
- G. 预测器–校正器采样器: 预测器为逆向 SDE 求解器、校正器为基于分数的 MCMC(算法 1–5),校正步长由信噪比 $r$ 决定;训练沿用原始 SMLD/DDPM 目标与 1000 个噪声尺度,P2000 需对尺度插值,LSUN 上固定 $r = 0.075$,末尾用 Tweedie 公式去噪。
- H. 架构改进: 引入 FIR 抗锯齿、跳跃连接缩放 $1 / \sqrt{2}$、BigGAN 残差 块、每分辨率 4 个残差块与渐进式增长,得 NCSN++(FID 2.45)与 DDPM++(2.78); 改用连续目标并加深后,NCSN++ cont. (deep) 达 FID 2.20 / IS 9.89,DDPM++ cont. (deep, sub-VP) 达 2.99 比特/维度;并在 $1024 \times 1024$ CelebA-HQ 上得到首个 高保真 $1024^2$ 分数模型样本。
- I. 可控生成: 用含时分类器实现类条件采样;修复通过把 SDE 限制到未知维度近 似;上色先用正交变换解耦通道再套用修复;一般逆问题由 $\nabla_x \log p_t(x(t)\mid y)\approx s_{\theta^*}(x(t),t)+ \nabla_x \log p_t(\hat y(t)\mid x(t))$(式 50)求解。
结语:从生成学习三难困境看扩散模型
若把生成学习的目标归纳为三点——(i) 高保真(样本逼真)、(ii) 高覆盖(不丢模态、不模式坍塌)、(iii) 高采样效率(少步、低延迟)——那么经典范式几乎都只能三取二,这就是 生成学习三难困境(Generative Learning Trilemma)(Xiao et al., 2021)。GAN 保真且快,却以模式坍塌与训练不稳定为代价;VAE、归一化流与基于能量的模型覆盖好(甚至可算似然)、采样尚可,却往往牺牲保真(模糊);而本报告所讨论的三篇论文奠基的扩散 / 分数模型走的是第三条路:以极强的保真与覆盖取胜,代价是采样极慢。
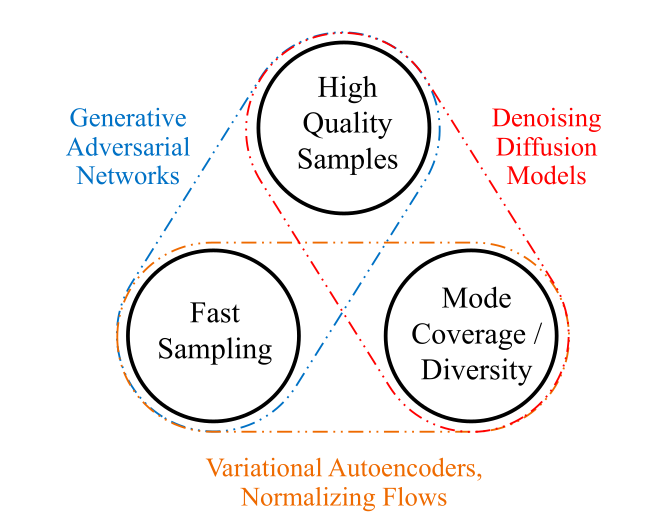
本篇报告的三篇论文恰好刻画了这条前沿如何被一步步推出来。SMLD 以分数匹配 + 退火 Langevin 证明“无需对抗训练也能高质量、多模态地生成”,但采样要在 $L$ 个噪声尺度上各跑上百步 Langevin;DDPM 用变分推断把目标化归为一个稳定、易训练的去噪问题,把保真推到 FID 3.17,代价仍是 $T = 1000$ 步的顺序去噪(256 张样本约 17 秒);Score-SDE 则把这一权衡显式暴露:它把 SMLD/DDPM 统一为两条 SDE 的离散化,并给出可调节的采样器——预测器–校正器(PC)在同等算力下改善质量,概率流 ODE + 黑盒求解器把函数评估次数削减 90% 以上而不损视觉质量,还首次让扩散模型能算精确似然。但作者本人也承认:采样仍明显慢于 GAN。换言之,三篇论文并未消除三难困境,而是把它的可行边界大幅推进,并把“慢采样”这一代价摆到台面上;此外,可控生成 / 逆问题(Score-SDE §5)实际上给三难困境又加了第四根轴:可控性。
值得强调的是,三难困境的三根轴并不等难:扩散模型真正解锁的是“保真 + 覆盖”这对最难兼得的组合(无需对抗训练、目标稳定、教训可复现),而它所支付的成本是可预测、可优化的,这为后续工作提供了清晰的着力点。(lazypool: 终于写完了)