重温 BART: 从开天辟地的原始蛮荒说起
CONTENTS
lazypool 的碎碎念:都 2026 年了,为什么还在写 BART 的论文阅读笔记,可能是因为某种怀旧的情结吧。虽然感觉这东西之后就被 GPT 全面替代了,立马化身时代的眼泪,但是它的一些思路和想法其实到今天也还是有在用到的。之后应当也要陆续补齐 Transformer, BERT, ElMo, GPT 系列的论文~
2018 到 2019 年,预训练语言模型还处在“开天辟地”的阶段:BERT 用双向编码器和掩码语言模型(Masked Language Model, MLM)把自然语言理解(NLU)推上了一个台阶,GPT 用单向自回归解码器证明了“预测下一个词”可以统一多种任务,XLNet、UniLM、MASS、SpanBERT 等则从掩码分布、预测顺序、注意力掩码、span 粒度等角度不断修补。可这些方法几乎都带有明显的“偏科”:BERT 系擅长理解却不擅长生成,GPT 系擅长生成却看不到右侧上下文,而 UniLM 虽然两边都沾,预测之间却是条件独立的。能不能用一个足够简单的框架,把“理解”和“生成”这两件事同时做好?
Facebook AI 的 BART: Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension(Lewis 等, arXiv:1910.13461,2019;后发表于 ACL 2020)给出了一个几乎“返璞归真”的答案:把预训练看成一个去噪自编码器(denoising autoencoder)——用任意噪声函数破坏文本,再让一个标准的 Transformer 序列到序列模型把原文重建出来。BART 这个名字来自 Bidirectional and Auto-Regressive Transformers:编码器双向、解码器自回归,于是它天然地把 BERT 和 GPT 装进了同一个模型。
本文严格按原论文的章节顺序展开:§1 引言、§2 模型、§3 微调、§4 预训练目标比较、§5 大规模实验、§6 定性分析、§7 相关工作、§8 结论;最后再单独讨论“BART 为什么重要”。文中图片与表格均直接从原论文 PDF 中裁出,公式编号沿用原文或显式标注为本文推导。
1 引言
论文开篇先复盘了自监督预训练的成功:从 word2vec、ELMo,到 BERT、XLNet、RoBERTa,最有效的一类方法都是掩码语言模型的变体——它们本质上都是去噪自编码器,训练模型重建“被随机遮掉一部分词”的文本。后续工作分别改进了被遮词元的分布(SpanBERT,遮连续 span)、被遮词元的预测顺序(XLNet,按排列顺序自回归预测)、以及替换被遮词元时可用的上下文(UniLM,用不同的注意力掩码)。但这些方法往往只服务于某一类下游任务(例如 span 预测、生成等),适用范围因此受限。
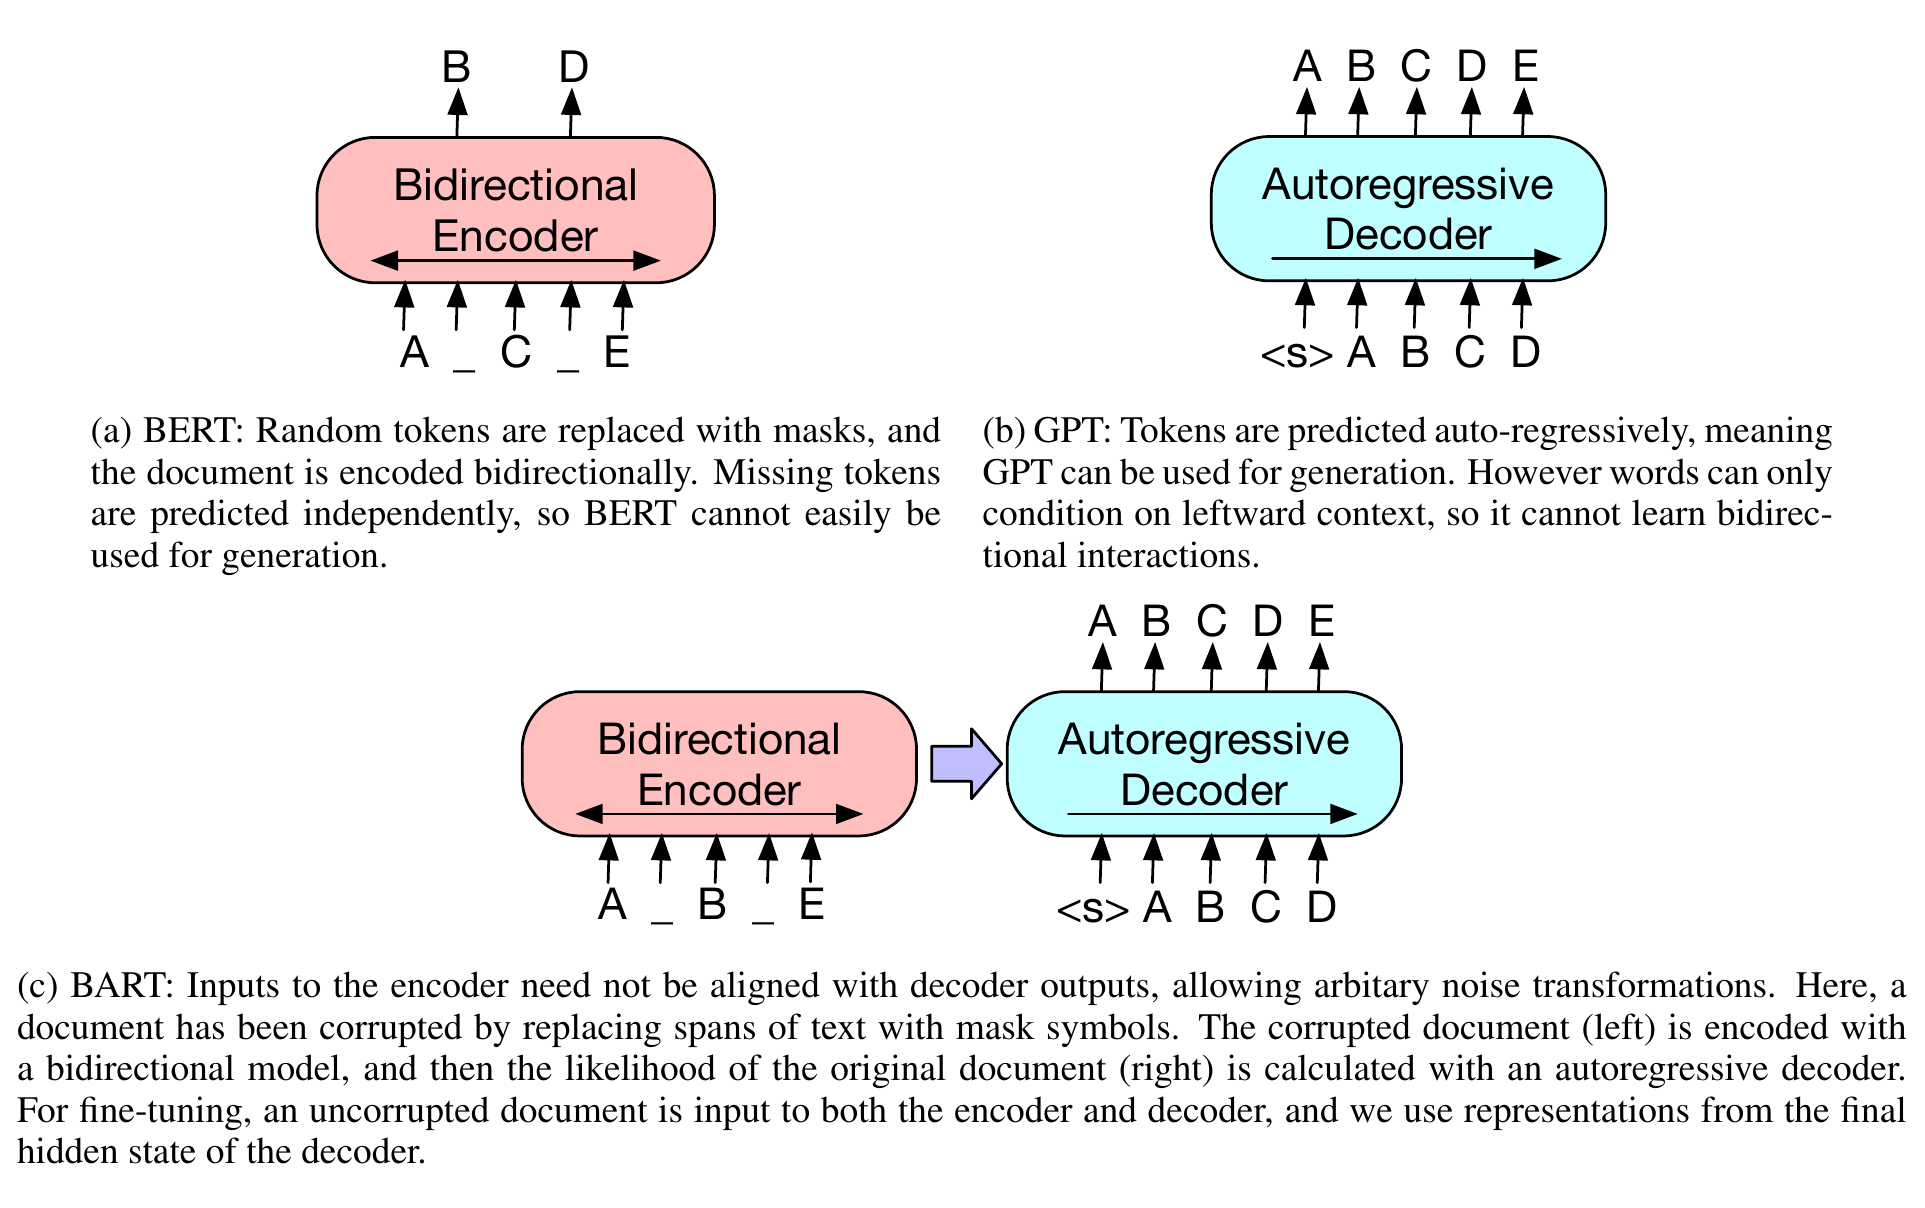
BART 的出发点是把“去噪”这件事做得更彻底:它是一个序列到序列的去噪自编码器,预训练分两步——(1) 用任意的噪声函数破坏文本,(2) 学习一个 seq2seq 模型重建原文。架构就是标准的 Transformer 机器翻译架构,简单到不能再简单,却可以被看作 BERT(因为编码器是双向的)与 GPT(因为解码器是从左到右自回归的)的推广,也覆盖了许多更晚出现的预训练方案(见图 1)。
这里最关键的一句话是:噪声函数可以是任意的,甚至可以改变文本长度。BERT 的掩码只能保持长度不变,而 BART 允许删除、插入、打乱句子顺序、旋转文档……这等于把“如何破坏输入”提升为一个可以自由设计的维度。作者试验了多种噪声方式,发现最佳组合是随机打乱原句顺序加上一种新的填充式(in-filling)方案:把任意长度的连续 span(包括长度为零的 span)替换成单个 mask 词元。这个目标推广了 BERT 原来的“词掩码 + 下一句预测”,迫使模型去推断整体句子长度,并对输入做更长程的变换。
效果上,BART 在生成任务上尤其强,在理解任务上也不弱:在与 RoBERTa 可比的计算资源下,它在 GLUE 和 SQuAD 上追平 RoBERTa;在摘要、对话、问答等生成任务上刷新了当时的 state-of-the-art,例如在 XSum 上比此前工作提升约 6 个 ROUGE。它还顺便打开了微调的新思路:在机器翻译中,把一个 BART 模型叠在少量额外的 Transformer 层之上,让这些层学会“把外语翻译成带噪英语”,再借 BART 把它去噪成英语——相当于把 BART 当成预训练的 目标端语言模型。在 WMT Romanian-English 上,这比一个很强的回译(back-translation)基线还高 1.1 BLEU。
最后,论文强调他们还做了一个受控的消融研究:在尽量相同的数据、算力、架构和微调流程下重新实现此前的多种预训练目标,以便回答一个被数据规模掩盖的问题——到底哪些因素真正影响下游性能。结果是 BART 在所考虑的全谱系任务上表现最稳定。
2 模型
BART 是一个把被破坏的文档映射回原始文档的去噪自编码器。实现上,它是一个 seq2seq 模型:编码器双向地读入被破坏的文本,解码器从左到右自回归地生成原文;预训练时优化原文档的负对数似然。
2.1 架构
BART 采用 Vaswani 等人提出的标准 seq2seq Transformer 架构,只做了两处小改动:跟随 GPT,把 ReLU 激活换成 GeLU;参数按 $\mathcal{N}(0,0.02)$ 初始化。base 模型编码器、解码器各 6 层,large 模型各 12 层。它与 BERT 的差异主要有两点:
- 解码器的每一层都会对编码器的最终隐层做交叉注意力(cross-attention),这正是 Transformer seq2seq 的标准做法;
- BERT 在词预测之前还有一层额外的前馈网络,BART 没有。
因此,在同等规模下,BART 比 BERT 多出大约 10% 的参数。
2.2 预训练 BART
BART 的训练方式可以写得很直白:先破坏文档,再优化重建损失——解码器输出与原始文档之间的交叉熵。设原始文档为 $x =(x_1,\dots,x_{|x|})$,噪声函数为 $C(\cdot)$,则
$$ \mathcal{L}_{\text{BART}}(\theta)= \mathbb{E}_{x\sim\mathcal{D}} [- \log p_\theta \bigl(x \mid C(x)\bigr)]= \mathbb{E}_{x\sim\mathcal{D}} [- \sum_{t=1}^{|x|} \log p_\theta \bigl(x_t \mid x_{\lt t},, C(x)\bigr)]. \tag {本文式 1} $$
这里要特别注意两路上下文的分工:解码器在预测 $x_t$ 时,左侧前缀 $x_{\lt t}$ 是未破坏的原文(teacher forcing,输入右移一位的原文档),而编码器提供的是被破坏的 $C(x)$。这带来一个常被忽略的好处:解码器始终在“干净上下文”上训练,预训练与生成时的从左到右设定完全一致,从而缩小了预训练与生成任务之间的错配。(这一点正是 BART 与 UniLM 的关键区别之一,§7 还会再提。)
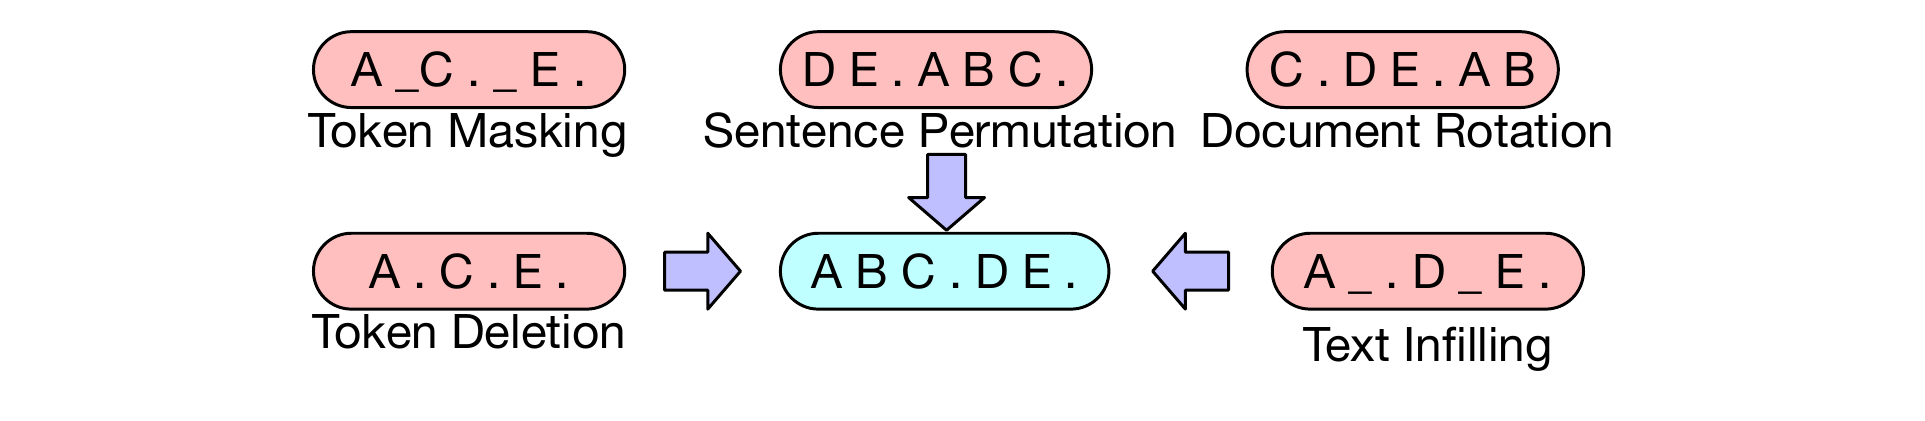
论文强调,与那些只针对特定噪声方案定制的去噪自编码器不同,BART 允许任意类型的文档破坏。极端情况下,如果破坏把源文档的信息全部抹掉,BART 就退化为一个普通的语言模型。他们试验了若干已有或新提出的变换(可组合使用),并相信这个空间里还有大量可探索的余地。具体如下,示意见图 2。
词元掩码(Token Masking)。 跟随 BERT,随机采样一些词元并替换为 [MASK]。
词元删除(Token Deletion)。 从输入中随机删除词元。与掩码不同,模型必须自己判断 哪些位置缺失了输入,而不是看到显式的占位符。
文本填充(Text Infilling)。 采样若干文本 span,span 长度从泊松分布 $\ell \sim \mathrm{Poisson}(3)$ 中抽取;每个 span 被替换成单个 [MASK] 词元。长度为零的 span 相当于在对应位置插入一个 [MASK]。这个目标受 SpanBERT 启发,但与 SpanBERT 有两点不同:SpanBERT 从截断几何分布采样长度,并且用与 span 等长的一串 [MASK] 替换。BART 只给一个 mask,因此模型必须学会推断缺失了多少个词元。
句子置换(Sentence Permutation)。 按句号把文档切成句子,再随机打乱这些句子的顺序。模型因此必须学习句子之间以及全局层面的顺序结构。
文档旋转(Document Rotation)。 均匀随机地选一个词元,把文档旋转到以它开头。这个任务训练模型识别文档的起点。
3 微调 BART
预训练得到的表示可以按下游任务的性质,以几种不同的方式接入。
3.1 序列分类任务
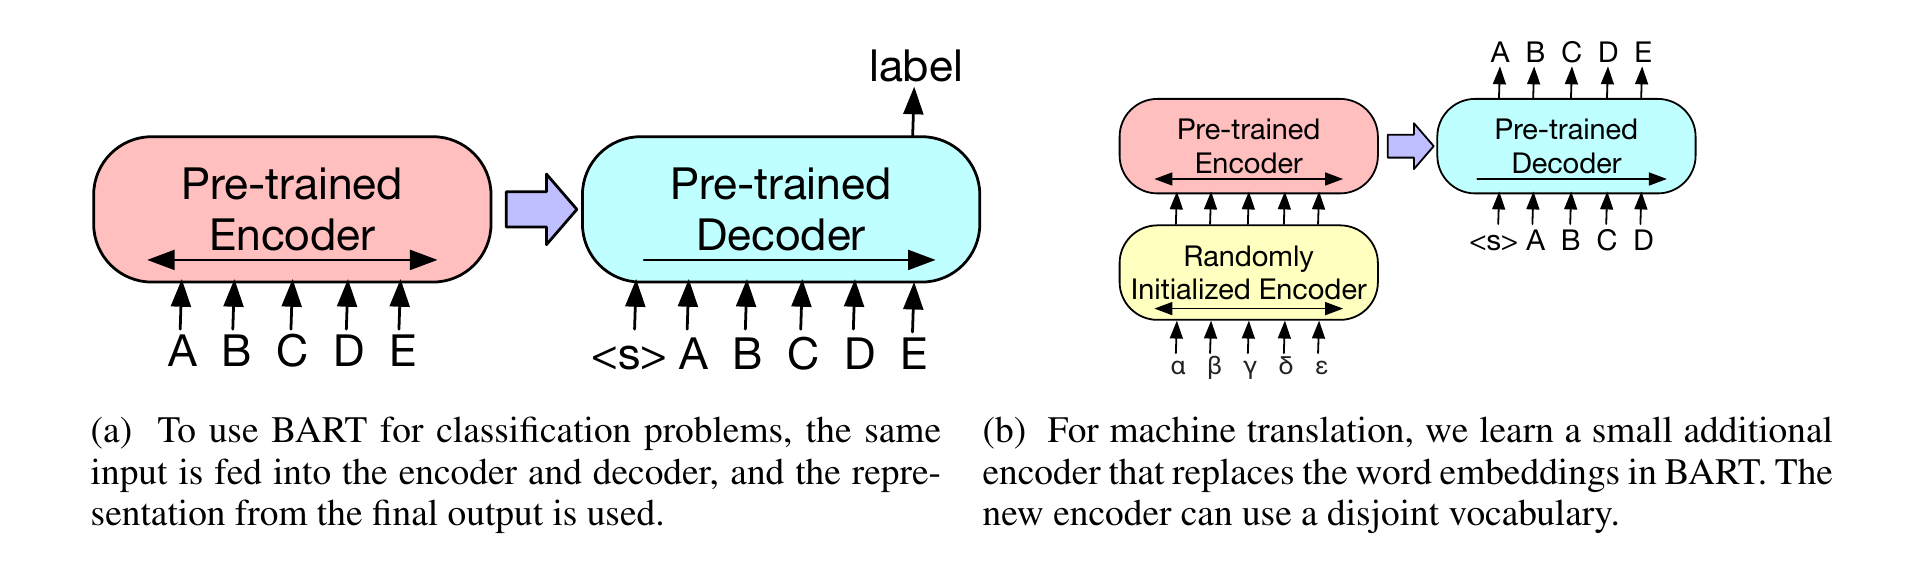
对于序列分类,同一份输入同时喂给编码器和解码器,然后把解码器最后一个词元的最终隐状态送入一个新的多分类线性分类器。这与 BERT 的 [CLS] 思路相关,但 BART 把额外词元加在末尾,这样该词元在解码器中就能注意到完整输入的表示(图 3a)。
3.2 词元分类任务
对于词元级分类(例如 SQuAD 的答案起止位置分类),把完整文档同时送入编码器和解码器,用解码器每个词元的顶层隐状态作为该词的表示,再据此分类。
3.3 序列生成任务
因为 BART 自带自回归解码器,它可以直接微调用于摘要、抽象问答等序列生成任务。这类任务需要从输入中“复制并改写”信息,与去噪预训练的目标高度同构:编码器输入是源序列,解码器自回归地生成输出。
3.4 机器翻译
论文还探索了用 BART 改进翻译成英语的解码器。此前 Edunov 等的工作表明,引入预训练编码器能带来提升,但把预训练语言模型用于解码器时收益有限。BART 的做法更进一步:把 整个 BART(编码器 + 解码器)当作一个预训练解码器,再额外加一个从双语语料学习的新编码器(图 3b)。
具体而言,他们替换掉 BART 原来的编码器嵌入层,换成一个随机初始化的新编码器;新编码器可以拥有与 BART 不同的词表。整个模型端到端训练,新编码器的任务就是把外语词映射成一种 BART 能“去噪成英语”的输入。源编码器分两步训练,两步都从 BART 输出端反传交叉熵:第一步冻结 BART 的大部分参数,只更新随机初始化的源编码器、BART 的位置嵌入,以及 BART 编码器第一层的自注意力输入投影矩阵;第二步再用少量迭代训练全部参数。
4 比较预训练目标
BART 支持的噪声方案远多于此前工作。为了弄清“目标函数”本身的影响,作者用 base 规模(编码器、解码器各 6 层,隐层 768)系统比较了一组目标,并在 §5 全量实验所用任务的一个代表性子集上评估。
4.1 对比目标
论文先指出了一个方法论难题:此前各种预训练目标之间很难公平比较,因为训练数据、训练资源、架构、微调流程都不一样。他们尽量控制这些无关变量,重新实现了近期提出的强预训练方法,只在学习率和 LayerNorm 的使用上做少量调整(并为每个目标单独调参)以改善性能。作为参照,还列出了 BERT 的已发表数字(同样在 books + Wikipedia 上训练 1M 步)。
被比较的目标包括:
- 语言模型(Language Model):类似 GPT,训练一个从左到右的 Transformer 语言模型,等价于去掉交叉注意力的 BART 解码器。
- 置换语言模型(Permuted Language Model):基于 XLNet,采样 $1 / 6$ 的词元,按随机顺序自回归生成。为保持一致性,没有实现 XLNet 的相对位置嵌入和跨段注意力。
- 掩码语言模型(Masked Language Model):跟随 BERT,把 15% 的词元替换为
[MASK],独立预测原词元。 - 多任务掩码语言模型(Multitask Masked Language Model):类似 UniLM,在 MLM 基础上加入额外的自注意力掩码,比例随机取:$1 / 6$ 从左到右、$1 / 6$ 从右到左、$1 / 3$ 不掩码、$1 / 3$ 前 50% 不掩码且后半段从左到右。
- 掩码序列到序列(Masked Seq-to-Seq):受 MASS 启发,遮住包含 50% 词元的一个 span,训练 seq2seq 模型预测这些被遮词元。
对置换 LM、掩码 LM 和多任务掩码 LM,作者使用 XLNet 式的双流注意力(two-stream attention)来高效计算输出部分似然(输出端用对角自注意力掩码,从左到右预测)。
对每个任务,他们还试了两种接法:(1) 当成标准 seq2seq,源输入给编码器、目标给解码器; (2) 把源作为前缀拼到解码器目标前,只在目标部分算损失。结论是前者更适合 BART,后者更适合其他模型。为了最直接地比较各模型对其微调目标的建模能力(即人类文本的对数似然),结果用困惑度(PPL)报告(表 1)。
4.2 任务
- SQuAD 1.1:维基百科段落上的抽取式问答,答案是文档中的文本 span。与 BERT 类似,把问题与上下文拼接后送入编码器,同时也送入解码器;模型带有预测每个词元起止位置的分类器。
- MNLI:句子对分类,判断一句是否蕴含另一句。微调时把两句用 EOS 拼接后同时送入 BART 的编码器与解码器;与 BERT 不同,用 EOS 的表示做分类。
- ELI5:长文本抽象问答数据集,模型在问题与支撑文档拼接后生成答案。
- XSum:高度抽象式的新闻摘要数据集。
- ConvAI2:对话回复生成,条件为上下文与一段文本化的人设(persona)。
- CNN/DM:新闻摘要数据集,摘要通常与原文句子关系密切。
4.3 结果
表 1 给出了结果,几条趋势相当清晰。
预训练方法的效果强烈依赖任务。 例如,一个简单的语言模型在 ELI5 上最好,在 SQuAD 上却最差。
词元掩码至关重要。 单独使用文档旋转或句子置换的目标表现很差;成功的方法要么使用词元删除/掩码,要么使用自注意力掩码。在生成任务上,删除似乎比掩码更好。
纯语言模型在 ELI5 上最强。 ELI5 是个异类:困惑度远高于其他任务,也是唯一一个 BART 被其他模型超过的生成任务。纯语言模型最好,说明当输出只被输入“松散约束”时, BART 的去噪目标并不占优。
BART 的表现最稳定。 除 ELI5 外,使用文本填充的 BART 在所有任务上都表现良好。
从左到右的预训练改善生成。 掩码 LM 和置换 LM 在生成上弱于其他模型,而它们恰好是仅有的两个在预训练中不包含从左到右自回归语言建模的模型。
双向编码器对 SQuAD 至关重要。 如先前工作所述,只有从左到右解码器时 SQuAD 表现很差,因为分类决策需要右侧上下文;而 BART 只用一半数量的双向层就达到了相近水平。
预训练目标不是唯一重要因素。 论文重实现的置换 LM 不如 XLNet,部分原因很可能是没有引入相对位置嵌入、段级循环等架构改进。
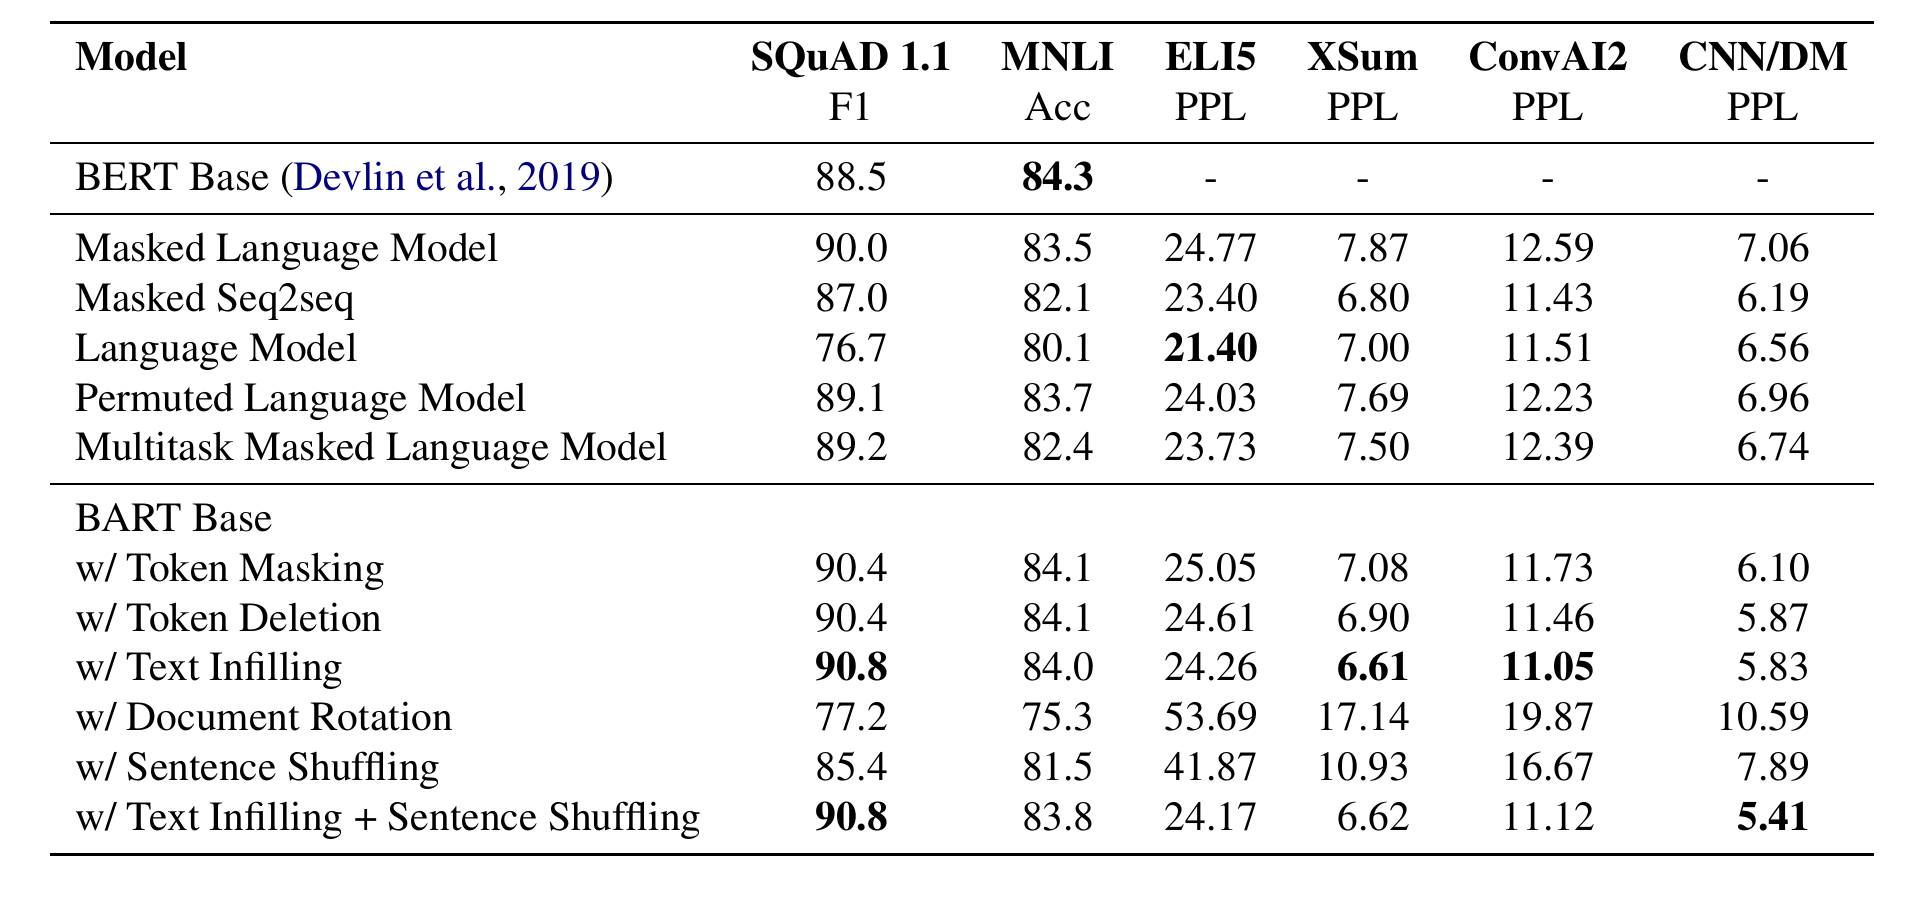
具体数字上,BART Base w/ Text Infilling + Sentence Shuffling 在 SQuAD 1.1 上达到 90.8 F1、MNLI 83.8 Acc、ELI5 24.17 PPL、XSum 6.62 PPL、ConvAI2 11.12 PPL、CNN/DM 5.41 PPL;作为对照,纯语言模型的 ELI5 PPL 是 21.40 (更低更好),但在 SQuAD 上只有 76.7。文档旋转单独使用时 SQuAD 仅 77.2、ELI5 PPL 高达 53.69;句子置换单独使用时 SQuAD 为 85.4、ELI5 PPL 为 41.87、 XSum PPL 为 10.93——这说明“能重建长度和顺序”本身并不够,必须让模型面对“缺失内容”的推断。文本删除在生成任务上确实略优于掩码(XSum 6.90 vs 7.08,CNN/DM 5.87 vs 6.10),而文本填充又进一步把这些数字压到 6.61 / 5.83,验证了“让模型猜缺失长度”的价值。
5 大规模预训练实验
此前工作表明,把预训练扩展到更大的 batch 和语料,下游性能会显著提升。为了检验 BART 在这个 regime 下的表现,并得到一个真正可用的下游模型,作者按 RoBERTa 的规模训练了 BART。
5.1 实验设置
large 模型编码器、解码器各 12 层,隐层 1024。跟随 RoBERTa,batch size 取 8000,训练 500000 步;文档用与 GPT-2 相同的 byte-pair encoding 分词。根据 §4 的结论,预训练噪声采用文本填充 + 句子置换的组合:每篇文档遮住 30% 的词元,并置换所有句子。论文提到,句子置换只在 CNN/DM 摘要数据集上带来显著的额外收益;他们推测更大的预训练模型更能从该任务中学习,因此在训练最后 10% 的步数里关闭了 dropout,让模型更好地拟合数据。预训练数据与 RoBERTa 相同,共 160GB,涵盖新闻、书籍、故事与网页文本。
5.2 判别任务
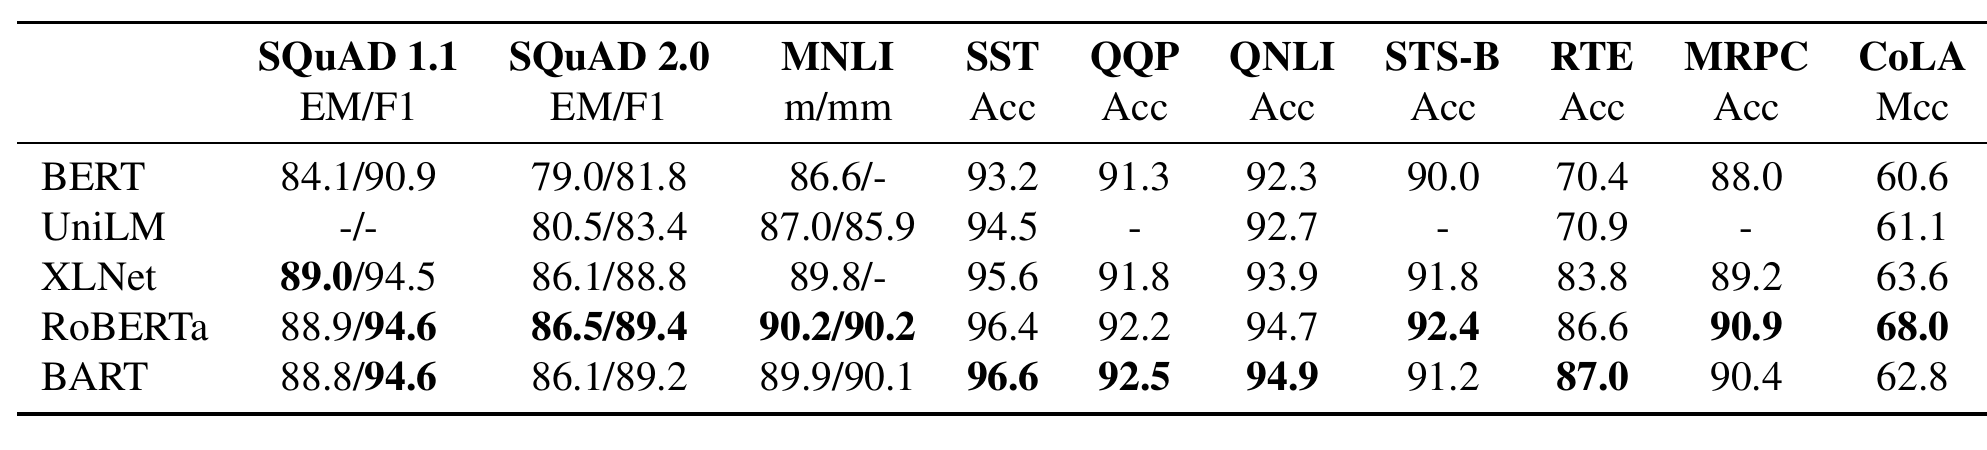
表 2 把 BART 与近期若干方法在 SQuAD 和 GLUE 上做了比较。最直接的可比基线是 RoBERTa:同样的预训练资源,但目标函数不同。总体上 BART 与之相当,多数任务只有很小差异,说明 BART 在生成任务上的提升并不是以分类性能为代价换来的。
逐项看,BART 的 SQuAD 1.1 为 88.8/94.6(EM/F1),与 RoBERTa 的 88.9/94.6 几乎持平;SQuAD 2.0 为 86.1/89.2,略低于 RoBERTa 的 86.5/89.4;MNLI 为 89.9/90.1,也略低于 90.2/90.2。GLUE 上 BART 在 SST(96.6)、QQP(92.5)、 QNLI(94.9)、RTE(87.0)上甚至略高于 RoBERTa,在 STS-B(91.2)、MRPC (90.4)上接近,在 CoLA 上明显偏低(62.8 vs 68.0)。这张表想传达的核心信息不是“每一项都赢”,而是理解任务的性能基本没有因生成式架构而受损。
5.3 生成任务
生成任务上,BART 被当作标准 seq2seq 模型微调;损失使用 label smoothed cross entropy (平滑参数 0.1)。生成时 beam size 取 5,去掉 beam search 中重复的 trigram,并在验证集上调 min-len、max-len 与 length penalty。
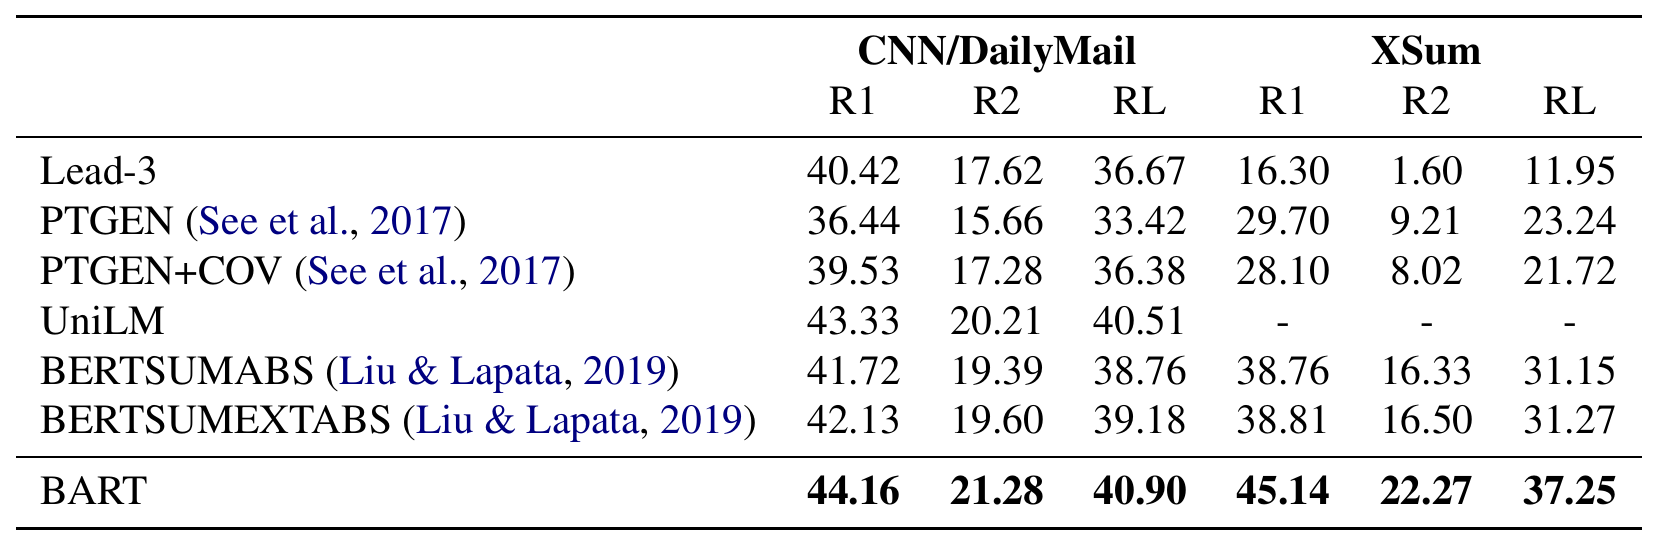
摘要。 论文选了性质截然不同的两个数据集。CNN/DailyMail 的摘要往往接近原文句子,抽取式模型表现很好,甚至“取前三句”的 Lead-3 基线都很有竞争力;即便如此,BART 仍超过所有已有工作,R1/R2/RL 达到 44.16/21.28/40.90。XSum 则高度抽象,抽取式模型很差;BART 比此前基于 BERT 的最好工作高出约 6.0 个 ROUGE(45.14/22.27/37.25 vs 38.81/16.50/31.27),是这张表里最醒目的跃迁。
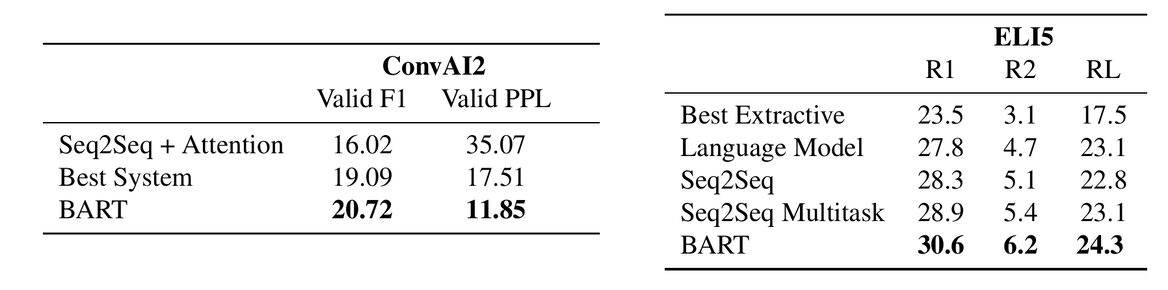
对话。 在 ConvAI2 上,智能体需要同时根据上一轮上下文和一段文本化人设生成回复。 BART 的两个自动指标都超过此前工作:Valid F1 20.72、Valid PPL 11.85(对比最强系统的 19.09 / 17.51)。
抽象问答。 在 ELI5 上,BART 比此前最好工作高 1.2 ROUGE-L(24.3 vs 23.1),但作者也坦言该数据集仍然很难,因为答案只被问题“弱指定”。
5.4 翻译
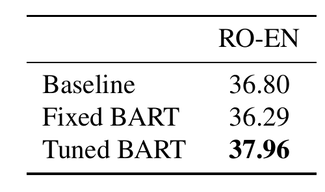
在 WMT16 Romanian-English(并用 Sennrich 等的回译数据增广)上,他们用一个 6 层 Transformer 源编码器把罗马尼亚语映射成 BART 能去噪成英语的表示,方法即 §3.4。beam width 5,length penalty $\alpha = 1$。表 6 中,基线是 Transformer-large;Fixed BART 对应第一步(冻结大部分 BART),Tuned BART 对应第二步(全部参数微调)。最终 37.96 BLEU,比强回译基线 36.80 高 1.16 BLEU;而只做第一步的 Fixed BART 只有 36.29,甚至略低于基线——说明“解冻并整体微调”这一步是必要的。作者也诚实指出:没有回译数据时该方法效果较差且容易过拟合,未来需要探索更多正则化手段。
6 定性分析
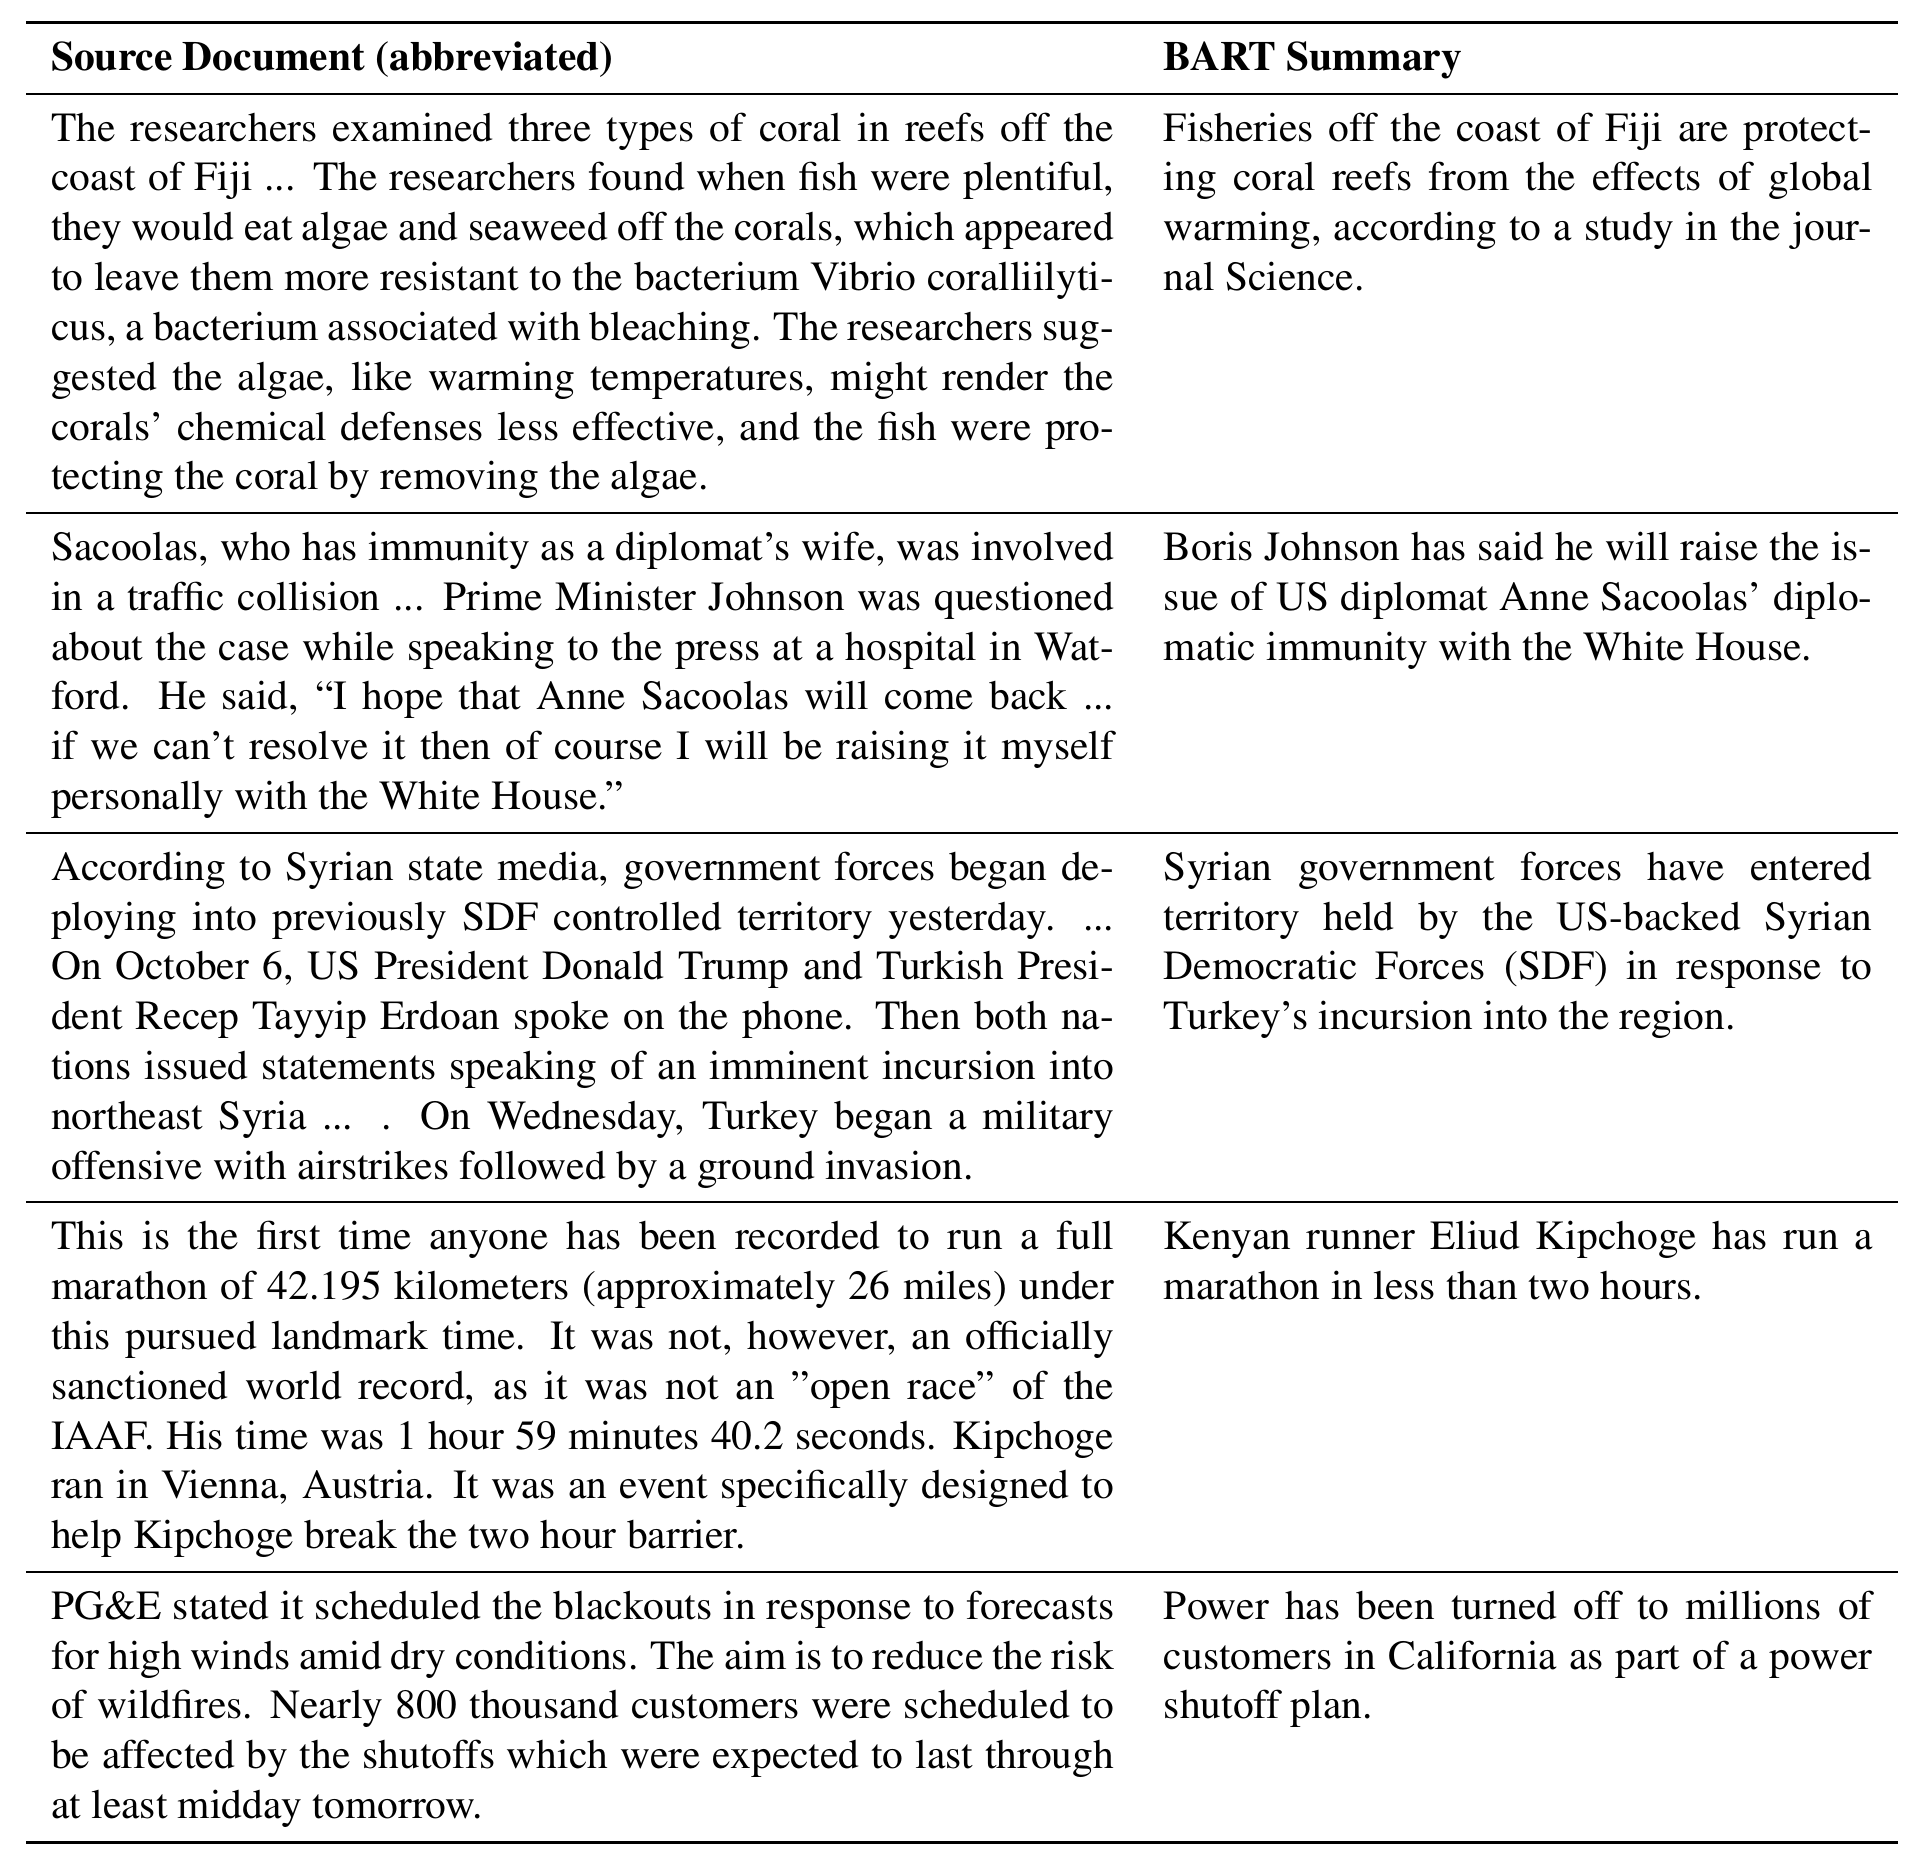
BART 在摘要指标上最多提升约 6 个点。为了理解自动指标之外的表现,论文对其生成结果做了定性分析(表 7)。例子取自预训练语料创建之后发表的 WikiNews 文章,以排除事件本身出现在训练数据中的可能;并跟随 Narayan 等的做法,在摘要前删掉文章第一句,这样就不存在一条容易的抽取式摘要。
结论是:模型输出是流畅、语法正确的英语,同时高度抽象——很少直接照抄输入短语;内容通常事实准确,并能把文档各处的证据与背景知识整合起来(例如正确补全人名,或推断出 PG&E 在加州运营)。第一个例子中,“鱼在保护珊瑚礁免受全球变暖影响”需要从文本做非平凡推理。不过也有错误:例如“该研究发表于 Science”这一说法并不被原文支持。这些样本说明,BART 的预训练确实学到了自然语言理解与生成的强组合。
7 相关工作
论文把预训练谱系梳理得很清楚。早期方法基于语言模型:GPT 只建模左侧上下文,对某些任务不利;ELMo 把从左、从右的表示拼接起来,但没有预训练二者之间的交互;Radford 等则展示了超大规模语言模型可以作为无监督多任务模型。
BERT 引入掩码语言模型,使预训练能够学习左右上下文的交互;后续工作通过更长训练(RoBERTa)、跨层参数共享(ALBERT)、遮 span 而非遮词(SpanBERT)进一步提升。但 BERT 的预测不是自回归的,这削弱了它在生成任务上的效果。UniLM 用一组注意力掩码微调 BERT,其中一些只允许左侧上下文,因而也能兼顾生成;区别在于 UniLM 的预测是条件独立的,而 BART 是自回归的。BART 还缩小了预训练与生成任务的错配,因为它的解码器始终在未破坏的上下文上训练。
MASS 可能是与 BART 最相似的模型:它把一个连续 span 被遮住的输入序列映射到“缺失词元”组成的序列。但 MASS 对判别任务效果较差,因为编码器和解码器看到的是不相交的词元集合。XLNet 则把 BERT 扩展为“按随机排列顺序自回归地预测被遮词元”,使预测能同时条件于左右上下文;而 BART 的解码器在预训练时是从左到右的,与生成时的设定一致。
机器翻译方面,已有工作探索过用预训练表示改进翻译。最大的收益来自源语言和目标语言都预训练(如 MASS、XLM),但这要求对感兴趣的每种语言都做预训练;也有工作表明编码器可以借助预训练表示改进,但解码器的收益更有限。BART 展示的正是如何用 BART 改进翻译解码器。
8 结论
论文的结论简洁有力:BART 是一种学习“把被破坏文档映射回原文”的预训练方法;它在判别任务上与 RoBERTa 相当,同时在多个文本生成任务上取得新的 state-of-the-art。未来工作应探索新的文档破坏方式,或许可以针对具体下游任务来定制噪声函数。
结语:BART 为什么重要
如果只把 BART 记成“又一个 BERT 变体”,就低估了它。它真正重要的地方,可以从下面几个层面来看。
第一,它把预训练从“某个固定目标”变成了“一个可设计的噪声函数”。 在 BART 之前,大家争论的是“遮 15% 还是遮 span”“按什么顺序预测”“用什么注意力掩码”;BART 把问题抽象为 $x \mapsto C(x)\mapsto x$:只要你能定义一种破坏方式,就能用它来预训练。这个视角统一了 BERT(只做词元掩码、独立预测)、GPT(不做破坏、纯自回归)、UniLM(用注意力掩码构造条件独立性)、MASS(连续 span 的 seq2seq 重建)等一大类方法,也为后来的 mBART、各种 denoising seq2seq 目标、乃至文本扩散/去噪生成提供了概念上的母版。“噪声函数”成为与“架构”“数据”并列的一等公民,这是 BART 最深远的贡献。
第二,它证明了同一个预训练模型可以同时做好理解与生成。 在此之前,社区里有一种默认分工:BERT 系做 NLU,GPT 系做 NLG。BART 用同一套参数在 GLUE/SQuAD 上追平 RoBERTa,又在 XSum 上把此前最好结果拉高约 6 个 ROUGE、在 ConvAI2 和 ELI5 上刷新 SOTA。这种“理解不降、生成大涨”的结果,直接支撑了后来 encoder-decoder 预训练路线(与 BART 同期的 T5 是另一条重要证据),也让“预训练一个 seq2seq 模型,然后按任务微调”成为生成任务的标准范式。
第三,文本填充目标本身很有价值。 用单个 mask 替换一个长度服从泊松分布的 span,迫使模型推断“少了几个词”,而不是像 SpanBERT 那样照着等长占位符填空;再叠加句子置换,迫使模型建模长程结构。§4 的受控实验说明,这两者组合后在所有生成任务上都最稳定。这个“span 级去噪 + 长度推断”的思想,后来被大量摘要、对话、翻译系统继承。
第四,它的消融方法论值得单独记一笔。 预训练研究很容易被“数据更多、算力更大、训练更久”混淆。BART 在相同代码库、相同数据、相同微调流程下重实现多种目标,并明确指出:预训练目标不是唯一因素,架构细节(如相对位置、段级循环)同样重要。这种受控比较的做法,后来成为预训练论文的标配。
第五,它给出了“预训练模型作为模块”的范式。 机器翻译里把 BART 整体当作目标端语言模型、在前面接一个小源编码器,只训练少量参数就能超过强回译基线,这说明预训练模型不必被当成一个黑箱端到端系统,而可以像积木一样嵌进现有流水线。mBART 后来把这一思路扩展到多语言,正是沿着这条线走的。
当然,BART 也有清晰的局限,而这些局限恰好指出了后续方向:它的解码是自回归的,生成慢;对 ELI5 这类“输出只被输入弱约束”的任务,纯语言模型反而更好;置换 LM 的实现省略了 XLNet 的一些架构改进;预训练数据与规模仍然重要;翻译在无回译数据时容易过拟合。换言之,BART 并没有终结预训练竞赛,而是把“如何破坏文本、如何重建文本”这个问题摆到了台面中央。
回看标题里的“开天辟地”,BART 的意义或许正在于此:在 BERT 与 GPT 各自为营的蛮荒时代,它用最简单的 seq2seq 去噪框架把两条路接在了一起,并告诉后来者——真正重要的不只是模型长什么样,更是你让它从什么样的噪声里恢复出什么样的世界。(lazypool: 这篇 BART 读下来,最深的感受是“噪声函数即归纳偏置”。)