老生常谈🗣:“进程、线程、协程”的相关概念汇总辨析
CONTENTS
“请叙述下你对进程、线程、协程的概念的理解。” ——阿里面试题目
进程、线程、协程
关于进程、线程、协程的考察,几乎是面试中的“常青题”了。 许多人都会感觉到:在平时工作中,潜意识能将这些概念区分得很清楚,但一旦要通过口语把它表达出来,就很抓瞎,“理不明白,说不清楚,缺乏逻辑”。 如果你也有这种感受,那么这篇博客可能能够帮助到你。
进程 Process
简言之,进程是操作系统分配资源的最小单位,其本质是处于执行状态的程序实例。这里的执行并非进程的 running 状态,而是指程序被加载到内存中,并按指令执行任务。当程序从硬盘加载到内存后,OS 为其创建进程控制块 PCB 并向其中分配计算和存储资源,包括:
- 进程标识符 PID (Process IDentifier)
- 进程状态 (新建、运行、就绪、阻塞)
- 内存资源 (代码段、数据段、堆、栈)
- IO 资源 (标准输入输出、文件标识符列表、网络连接)
- 程序计数器 PC、CPU 寄存器
- 父进程 PID、子进程 PID,等等
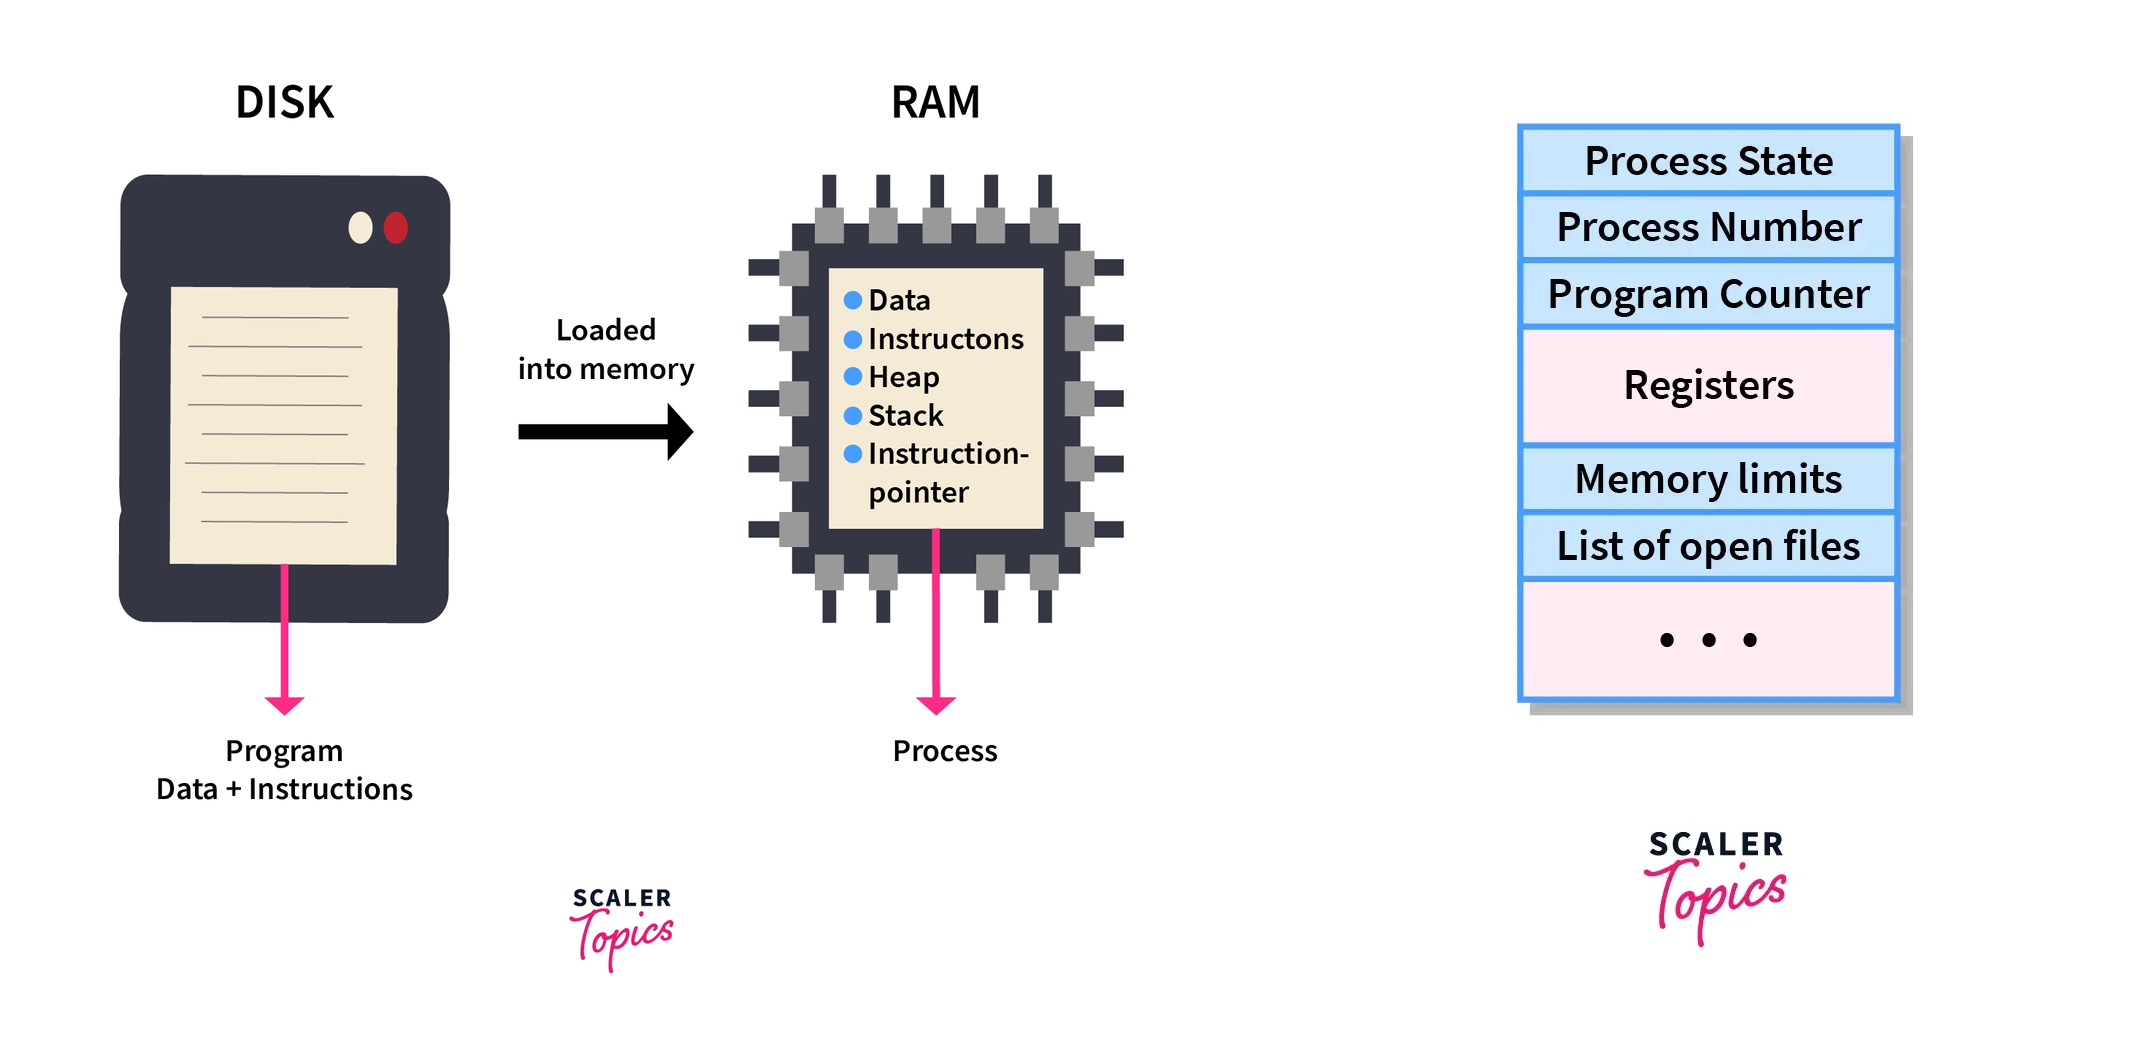
OS 使用虚拟内存,利用硬盘空间来扩展内存容量。物理内存不足时,OS 将部分不常用的内存数据写入硬盘上的虚拟内存文件,腾出物理内存空间来运行其他程序和数据。当需要访问这些数据时,OS 会将它们重新加载到物理内存中。为此,OS 维护一张地址映射表,将程序的虚拟地址映射到物理地址。当虚拟内存被用到时,这些地址会映射到硬盘上的虚拟内存文件,而非物理内存。
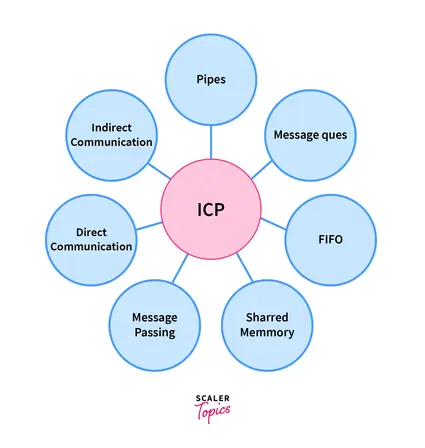
虚拟内存使每个进程都拥有独立的虚拟地址空间,这使得每个进程都认为自己是独占 OS 的,从而使得进程与进程之间处在互不可见的隔离状态下。有时,会需要多个进程协作完成一项任务,就会不可避免地引入进程间通信 IPC。常用的进程间通信手段大概有 6 种:共享内存、消息队列、匿名管道、命名管道、Signal 信号和Socket 套接字,这几种方式根据需求的不同各有自己的用武之地。
线程 Thread
线程是操作系统执行调度的最小单位,是进程内部的任务执行单元,由指令流和数据流交织而成。对于单线程进程而言,线程与进程概念等价;然而对于多线程进程,同一进程内的多个线程共享进程资源,但拥有各自独立的执行上下文。OS 调度 CPU 时以线程为单位,其核心特性包括:
- 调度单位:是 OS 调度的基本单元,通过时间片轮转实现并发
- 共享资源:同一进程的线程共享代码段、数据段、文件描述符等
- 独立堆栈:每个线程拥有独立的堆、栈空间和寄存器状态
- 轻量级创建:线程创建通过
clone()系统调用实现,比进程的fork()更高效
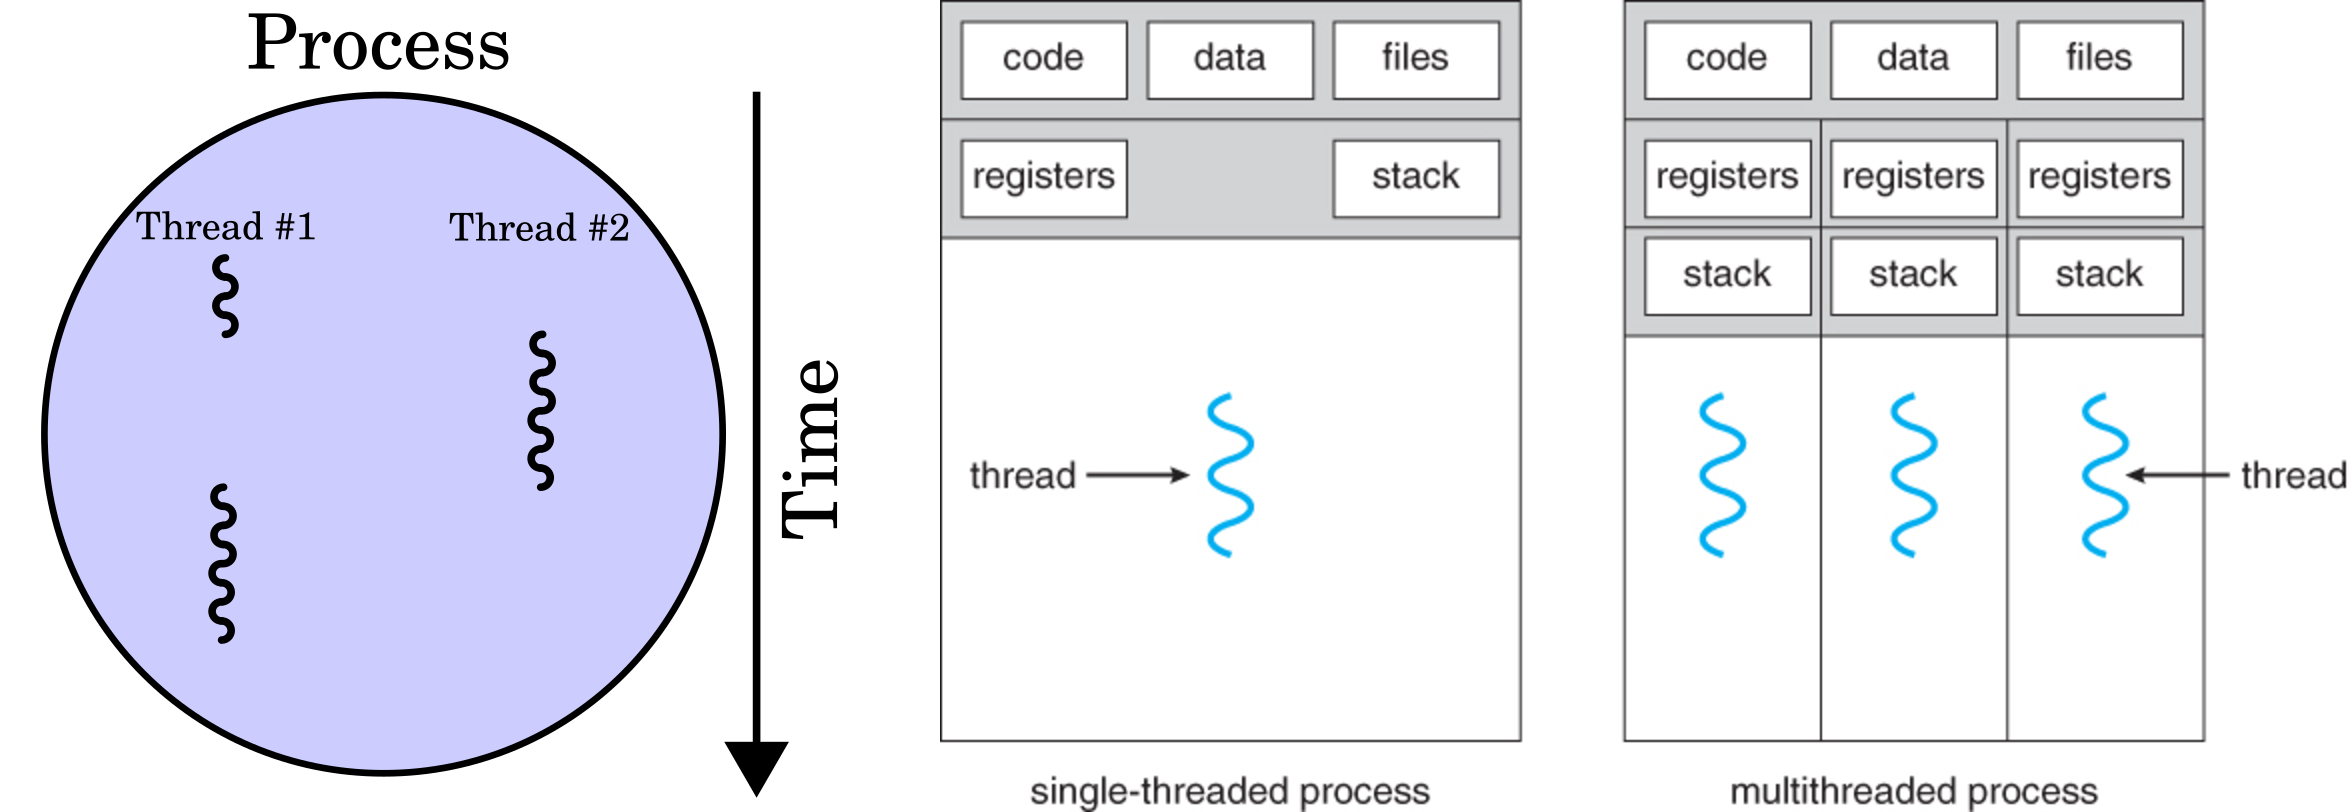
线程通过共享内存实现高效协作。由于共享进程地址空间,线程间通信可直接访问共享内存,无需复杂 IPC 机制,只需要使用一些编程上的技法就可以完成通信: 互斥锁 (Mutex)、条件变量 (Condition Variable)、信号量 (Semaphore)、原子操作 (Atomic Operations)、阻塞队列 (Blocking Queue)。
进程 VS 线程特性对比
| 特性 | 进程 | 线程 |
|---|---|---|
| 资源分配 | OS 分配独立资源 | 共享进程资源 |
| 创建开销 | 高,需复制父进程资源 | 低,共享现有资源 |
| 上下文切换 | 涉及内存地址切换 | 仅切换寄存器状态 |
| 通信机制 | IPC 如管道、共享内存等 | 直接内存访问加同步机制 |
| 崩溃影响 | 独立运行,不影响其他进程 | 可能导致整个进程终止 |
使用多线程时要考虑任务自身的需求,以及使用多线程能带来多大的收益。通常,多线程适用于可划分为多个独立子任务,且子任务间没有重叠、无需通信的计算密集型任务,如矩阵运算、图像分块处理等。在收益方面,使用多线程的加速比 $S$ 由并行部分的比例 $P$ 和核心数 $N$ 共同决定:
$$ S = \frac{1}{1-P+\frac{P}{N}} \quad(\mathsf{Amdahl’s law}) $$
这意味着当并行部分占比较小,或者 CPU 的核心数过少时,使用多线程的收益将非常有限。 此外,除了并行占比和 CPU 核心数,多线程的效率还受制于内存限制和 I/O 带宽等因素。实际应用中,常以线程池的方式使用多线程。所谓线程池,就是在任务开始时创建多个线程并保存在池中,之后通过队列的形式将任务分配给各个线程。这种做法使程序员能自主控制线程,避免了重复创建、销毁线程带来的开销。
协程 Coroutine
与进程、线程不同,协程完全是编程层面,而非 OS 级别的概念,其本质是能够挂起和恢复的函数。普通函数仅有两种行为,调用 (call) 和返回 (return);而协程比起普通函数又多了挂起 (suspend) 和恢复 (resume) 的功能。因此,普通函数的程序执行流仅用栈就能处理,在调用时 push ,在返回时 pop;而协程还需要额外的暂存空间,以便在挂起时保存上下文,在恢复时读取上下文。
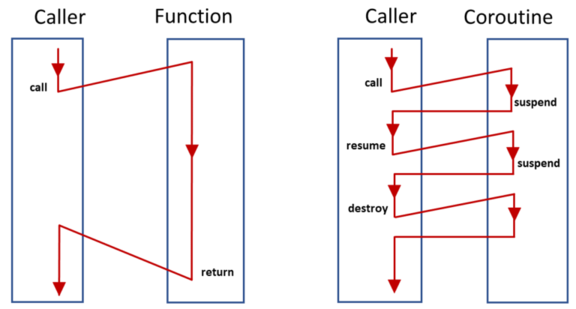
协程是一种通过单线程实现并发任务执行的编程机制,协程间切换的控制权是交由程序员掌握的。以经典的生产者-消费者任务为例,不同于创建两个进程或线程,协程通过在单线程内交替切换生产和消费的协程函数来实现:生产者协程生产一定数量之后挂起,并调用消费者协程;消费者协程消费完之后挂起,并调用生产者协程…… 如此交替往复进行。协程总是同步且并发的,于程序员而言,编写协程的心智负担更小,往往比线程更容易掌控。
无栈协程编译之前:
// 使用 async 关键字 |
无栈协程编译之后:
// 无栈协程其实就是这么实现的 |
协程分为有栈协程 (stackful) 和无栈协程 (stackless)。有栈协程通过为每个协程分配独立的调用栈实现上下文切换,允许在任意嵌套函数中挂起和恢复,具备更强的灵活性但资源消耗更高,典型代表如 Go 语言中的 goroutine。无栈协程则无需独立空间,通常基于状态机和语法糖 async/await 实现,仅能在特定调度点挂起,虽然轻量但控制粒度受限,例如 python 的生成器和 c# 中的异步函数。有栈和无栈的本质差异在于对执行上下文的保存方式:有栈协程依赖显式栈内存保存完整状态,而无栈协程通过编译器生成代码隐式管理状态。
总结部分
从进程到线程再到协程的概念,其使用层级是逐级向上的。
- 如果希望程序可以充分利用多核资源来实现 CPU 密集型操作的并行加速,那可以使用多线程,通过使用锁/条件变量等方式来完成线程之间的协作。
- 如果不满 OS 的任务/线程调度策略,那可以在程序中使用并调度协程,用单线程+协程挂起和恢复的逻辑来完成宏观上的并发操作。